AI Agent 上下文工程:流式中断、压缩、缓存与持久化#
流式输出与中断#
流式输出:像水流一样输出文字内容,逐字打印,避免用户在猜测模型是卡住了还是在干活,流式输出就刚好可以解决这个问题,同时,用户在监控输出时,也能随时中断,避免 agent 在错误的方向一去不复返。
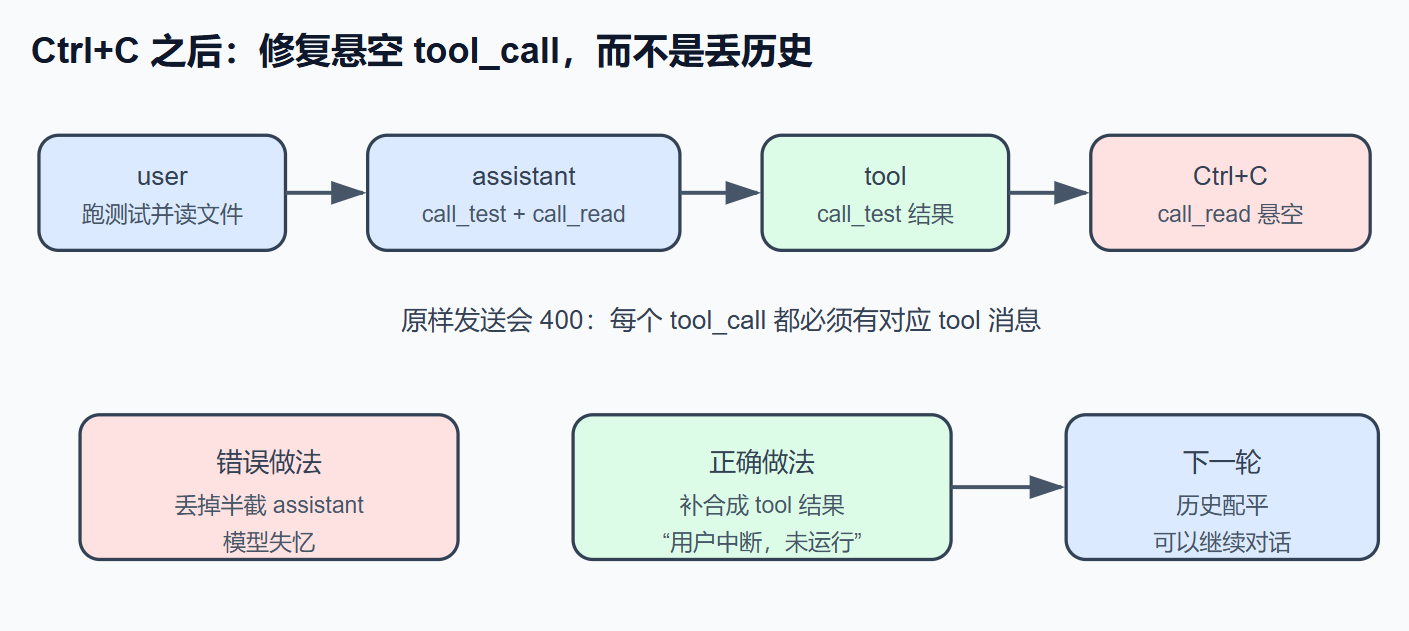
先补一个协议知识:模型想用工具时,会在回复(assistant 消息)里带一批 tool_calls,每个有唯一 id;协议要求每个 id 后面必须跟一条对应的 tool 消息(工具执行结果)。
看一下 Ctrl+C 那一刻的消息序列:
1
2
3
4
| user: "把测试跑一遍,顺便看下 README"
assistant: tool_calls: [call_test → run_shell, call_read → read_file]
tool: (call_test 的结果 —— 第一个工具跑完了)
← Ctrl+C 落在这里,call_read 永远没有结果
|
call_read 没有对应结果——原样发出去,服务端拒收(400)。而且流是中途切断的,call_read 的参数可能停在 JSON 中间({"path":"READ)。怎么处理这个残缺序列,决定了中断后会话能否继续。
悬空 tool_call 的报错原文:
OpenAI 大意是 “An assistant message with ’tool_calls’ must be followed by tool messages responding to each ’tool_call_id’";
Anthropic 的版本是 “tool_use ids were found without tool_result blocks”。
“parse 留到拼完之后"之所以顺手,是因为 s02 的分层里 dispatch 本来就在那时才 parse——分层带来的便利。
还有一个 readline 细节:终端在 readline 手里时处于 raw 模式,Ctrl+C 不产生进程信号,而是触发 rl 的 'SIGINT' 事件——所以 rl.on("SIGINT") 和 process.on("SIGINT")(非 TTY 时)都要监听。
解决方案#
流式侧:SSE 按行缓冲解析(凑齐完整的一行才处理一行),tool_calls 的分片按 index 装配,parse 留到拼完之后。中断侧:一个 AbortController 贯穿 HTTP 层与工具循环,已装配的半截消息照常保留在历史里;对 Ctrl+C 留下的悬空 tool_call,给每个没有结果的 tool_call 回填一条合成 tool 消息,把序列配平——会话就能继续。
实现:#
agent.mjs#
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
218
219
220
221
222
223
224
225
226
227
228
229
230
231
232
233
234
235
236
237
238
239
240
241
242
243
244
245
246
247
248
249
250
251
252
253
254
255
256
257
258
259
260
261
262
263
264
265
266
267
268
269
270
271
272
273
274
275
276
277
278
279
280
281
282
283
284
285
286
287
288
289
290
291
292
293
| #!/usr/bin/env node
// s05 —— Ctrl+C 之后:s03 的 agent + 流式输出 + 可恢复的中断。
//
// 在 s03 基底上的全部变化:
// · chat() 改为 stream:true,手工解析 SSE(见 stream.mjs),文本增量实时打印
// · 每轮一个 AbortController:第一次 Ctrl+C 中断本轮,第二次退出进程
// · 中断后调用 repairDanglingToolCalls 修复消息序列 —— 悬空的 tool_call
// 回填合成结果,下一句话不会再撞上 400
//
// 运行方式与 s03 相同:AGENT_API_KEY=sk-xxx node agent.mjs
import readline from "node:readline/promises";
import { execSync } from "node:child_process";
import { readFileSync, writeFileSync, mkdirSync } from "node:fs";
import path from "node:path";
import { LoopBudget, isRecoverable, repairPrompt } from "./loop-budget.mjs";
import { sseJsonEvents, createAssembler, repairDanglingToolCalls } from "./stream.mjs";
const BASE_URL = process.env.AGENT_BASE_URL ?? "https://api.deepseek.com/v1";
const API_KEY = process.env.AGENT_API_KEY;
const MODEL = process.env.AGENT_MODEL ?? "deepseek-chat";
if (!API_KEY) {
console.error("缺少 AGENT_API_KEY。任何 OpenAI 兼容的 key 都行(DeepSeek / Kimi / GLM / OpenRouter / 本地 Ollama)。");
process.exit(1);
}
const SYSTEM = `你是一个运行在用户终端里的编程助手。
优先用专用工具(read_file / write_file / edit_file)操作文件;run_shell 用于其余一切。
先观察真实世界再行动,不要凭空猜测文件内容。
当前目录:${process.cwd()}
操作系统:${process.platform}`;
// ─── 工具注册表(与 s03 相同)─────────────────────────────────────────────
const REGISTRY = {
run_shell: {
description: "在用户的终端里执行一条 shell 命令,返回 stdout 和 stderr。",
parameters: {
type: "object",
properties: { command: { type: "string", description: "要执行的命令" } },
required: ["command"],
},
handler: ({ command }) => {
console.log(`\x1b[33m $ ${command}\x1b[0m`);
try {
const out = execSync(command, {
encoding: "utf8",
timeout: 30_000,
maxBuffer: 1024 * 1024,
stdio: ["ignore", "pipe", "pipe"],
});
return out.trim() || "(命令执行成功,无输出)";
} catch (err) {
return `命令失败(exit ${err.status ?? "?"}):\n${err.stdout ?? ""}${err.stderr ?? err.message}`;
}
},
},
read_file: {
description: "读取一个文本文件,返回带行号的内容。",
parameters: {
type: "object",
properties: { path: { type: "string", description: "文件路径(相对或绝对)" } },
required: ["path"],
},
handler: ({ path: p }) => {
console.log(`\x1b[33m read ${p}\x1b[0m`);
const text = readFileSync(p, "utf8");
const CAP = 50_000;
const body = text.length > CAP ? text.slice(0, CAP) + `\n…(截断,共 ${text.length} 字符)` : text;
return body
.split("\n")
.map((line, i) => `${String(i + 1).padStart(4)}\t${line}`)
.join("\n");
},
},
write_file: {
description: "写入一个文件(整体覆盖)。父目录不存在时自动创建。",
parameters: {
type: "object",
properties: {
path: { type: "string", description: "文件路径" },
content: { type: "string", description: "完整的文件内容" },
},
required: ["path", "content"],
},
handler: ({ path: p, content }) => {
console.log(`\x1b[33m write ${p} (${content.length} 字符)\x1b[0m`);
mkdirSync(path.dirname(path.resolve(p)), { recursive: true });
writeFileSync(p, content);
return `已写入 ${p}`;
},
},
edit_file: {
description:
"对文件做一次精确替换。old_string 必须在文件中出现且仅出现一次(带上足够的上下文来保证唯一),否则会失败。",
parameters: {
type: "object",
properties: {
path: { type: "string", description: "文件路径" },
old_string: { type: "string", description: "要被替换的原文(必须唯一匹配)" },
new_string: { type: "string", description: "替换成的新文本" },
},
required: ["path", "old_string", "new_string"],
},
handler: ({ path: p, old_string, new_string }) => {
console.log(`\x1b[33m edit ${p}\x1b[0m`);
const text = readFileSync(p, "utf8");
const first = text.indexOf(old_string);
if (first === -1) return `编辑失败:old_string 在 ${p} 中找不到。请先 read_file 确认原文。`;
if (text.indexOf(old_string, first + 1) !== -1)
return `编辑失败:old_string 在 ${p} 中出现多次。请带上更多上下文让它唯一。`;
// 不能用 text.replace(old, new):new_string 里的 $$ / $& 会被 JS 当替换模式展开,静默写坏文件。
writeFileSync(p, text.slice(0, first) + new_string + text.slice(first + old_string.length));
return `已编辑 ${p}`;
},
},
};
const TOOLS = Object.entries(REGISTRY).map(([name, t]) => ({
type: "function",
function: { name, description: t.description, parameters: t.parameters },
}));
const FAILURE_RE = /^(命令失败|编辑失败|工具执行出错|未知工具|工具参数)/;
function dispatch(call) {
const tool = REGISTRY[call.function.name];
if (!tool) return `未知工具:${call.function.name}`;
let args;
try {
args = JSON.parse(call.function.arguments || "{}");
} catch (err) {
return `工具参数不是合法 JSON:${err.message}`;
}
try {
return tool.handler(args);
} catch (err) {
return `工具执行出错:${err.message}`;
}
}
// ─── 流式 chat:SSE 手工解析,文本增量实时打印 ───────────────────────────
async function chat(messages, signal) {
const res = await fetch(`${BASE_URL}/chat/completions`, {
method: "POST",
headers: {
"content-type": "application/json",
authorization: `Bearer ${API_KEY}`,
},
body: JSON.stringify({
model: MODEL,
messages: [{ role: "system", content: SYSTEM }, ...messages],
tools: TOOLS,
stream: true,
}),
signal, // 中断贯穿到 HTTP 层:abort 会掐断连接,流当场停
});
if (!res.ok) throw new Error(`API ${res.status}:${await res.text()}`);
const assembler = createAssembler();
let printed = false;
try {
for await (const event of sseJsonEvents(res.body)) {
const textDelta = assembler.feed(event);
if (textDelta) {
process.stdout.write(textDelta); // 用户看到的"打字机"就是这一行
printed = true;
}
}
} catch (err) {
// abort 掐断流时,body 迭代器会抛错(不同 Node 版本的错误类型不完全一致),
// 以 signal 为准:确实是中断就吞掉,装配器里已有的半截消息照常返回。
if (!signal.aborted) throw err;
}
if (printed) process.stdout.write("\n");
return { message: assembler.message(), aborted: signal.aborted };
}
// ─── 主循环:中断可以落在任何缝隙里,落点之后统一修复 ────────────────────
let activeTurn = null; // 当前这轮的 AbortController;null = 没有轮次在跑
function finishInterrupt(messages) {
const filled = repairDanglingToolCalls(messages);
console.log(
`\n\x1b[31m⏹ 本轮已中断${filled ? `,回填了 ${filled} 条合成工具结果` : ""}。会话可以继续。\x1b[0m`,
);
}
async function runTurn(messages) {
const budget = new LoopBudget({ baseSteps: 12 });
let repaired = false;
const controller = new AbortController();
activeTurn = controller;
try {
while (true) {
if (!budget.canContinue()) {
const stop = budget.exhaustedStop();
console.log(`\n\x1b[31m⛔ ${stop.message}(第 ${stop.turnCount} 轮)\x1b[0m`);
return;
}
// 中断也可能落在建连阶段(fetch 还没返回响应头):此时 AbortError 从
// await fetch 本身抛出,chat 里包住 body 迭代的 try/catch 接不到它。
let result;
try {
result = await chat(messages, controller.signal);
} catch (err) {
if (!controller.signal.aborted) throw err;
return finishInterrupt(messages); // 一个增量都没收到,修复后直接收场
}
const { message: msg, aborted } = result;
// 半截消息也要进历史:已经流出来的文字用户看到了,历史里没有的话,
// 模型下一轮就会"失忆",答非所问。空壳(没内容没调用)才丢弃。
if (msg.content || msg.tool_calls?.length) messages.push(msg);
if (aborted) return finishInterrupt(messages);
if (!msg.tool_calls?.length) return;
const records = [];
for (const call of msg.tool_calls) {
// 中断可以落在两次工具执行的缝隙里 —— 每次派发前重查,
// 已中断就跳过剩余调用(它们的悬空 tool_call 由修复函数回填)。
if (controller.signal.aborted) break;
const output = dispatch(call);
messages.push({ role: "tool", tool_call_id: call.id, content: output });
let input = {};
try {
input = JSON.parse(call.function.arguments || "{}");
} catch { /* 坏参数已作为失败回填 */ }
records.push({
name: call.function.name,
input,
status: FAILURE_RE.test(output) ? "failed" : "completed",
output,
});
}
if (controller.signal.aborted) return finishInterrupt(messages);
const stop = budget.recordTurn(records);
if (!stop) continue;
if (isRecoverable(stop) && !repaired) {
repaired = true;
console.log(`\n\x1b[35m🟡 看门狗触发(${stop.reason}),注入纠偏 prompt…\x1b[0m`);
messages.push({ role: "user", content: repairPrompt(stop) });
continue;
}
console.log(`\n\x1b[31m⛔ ${stop.message}(reason=${stop.reason},第 ${stop.turnCount} 轮)\x1b[0m`);
return;
}
} finally {
activeTurn = null;
}
}
// ─── Ctrl+C:第一次中断本轮,第二次退出 ──────────────────────────────────
function onInterrupt() {
if (activeTurn && !activeTurn.signal.aborted) {
activeTurn.abort();
console.log("\n\x1b[33m⚠ 正在中断本轮…(再按一次 Ctrl+C 退出)\x1b[0m");
} else {
console.log("\n再见。");
process.exit(0);
}
}
const rl = readline.createInterface({ input: process.stdin, output: process.stdout });
// 细节:终端在 readline 手里时处于 raw 模式,Ctrl+C 不会产生进程信号,
// 而是触发 rl 的 'SIGINT' 事件;stdin 不是 TTY(比如管道喂入)时才走
// process 的 'SIGINT'。两头都接到同一个处理函数上。
rl.on("SIGINT", onInterrupt);
process.on("SIGINT", onInterrupt);
const messages = [];
console.log(
`s05 agent 已上线(${MODEL},流式)。工具:${Object.keys(REGISTRY).join("、")}。` +
`任务跑着的时候按 Ctrl+C 试试 —— 中断之后接着聊,不会 400。`,
);
while (true) {
const line = (await rl.question("\n你> ")).trim();
if (!line) continue;
messages.push({ role: "user", content: line });
await runTurn(messages);
}
|
demo.mjs#
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
| #!/usr/bin/env node
// 不需要 API key 的流式与中断演示:
// 场景一:把一段 SSE 字节流故意切得支离破碎(掐在 data: 行中间、JSON 中间、
// 多字节字符中间),喂给解析器 + 装配器,看 tool_calls 分片怎么归队。
// 场景二:伪造一串被 Ctrl+C 撕成半截的 messages,跑修复函数,
// 看悬空的 tool_call 怎么被回填、断裂的参数怎么被修好。
//
// node s05_streaming_interrupt/demo.mjs
import { sseJsonEvents, createAssembler, repairDanglingToolCalls, INTERRUPT_NOTE } from "./stream.mjs";
// ─── 场景一:SSE 分片装配 ────────────────────────────────────────────────
console.log("━━━ 场景一:SSE 分片装配(tool_calls 按 index 归队)━━━");
// 服务端"本来想发"的事件序列:先流两段文本,再交错地流两个工具调用 ——
// call 0 的 arguments 被切成 3 片,中间还插进来 call 1 的分片。
const events = [
{ choices: [{ delta: { role: "assistant" } }] },
{ choices: [{ delta: { content: "我来" } }] },
{ choices: [{ delta: { content: "查一下。" } }] },
{ choices: [{ delta: { tool_calls: [{ index: 0, id: "call_ls", type: "function", function: { name: "run_shell", arguments: "" } }] } }] },
{ choices: [{ delta: { tool_calls: [{ index: 0, function: { arguments: '{"comm' } }] } }] },
{ choices: [{ delta: { tool_calls: [{ index: 1, id: "call_read", type: "function", function: { name: "read_file", arguments: '{"path":' } }] } }] },
{ choices: [{ delta: { tool_calls: [{ index: 0, function: { arguments: 'and":"ls' } }] } }] },
{ choices: [{ delta: { tool_calls: [{ index: 1, function: { arguments: '"a.txt"}' } }] } }] },
{ choices: [{ delta: { tool_calls: [{ index: 0, function: { arguments: ' -la"}' } }] } }] },
{ choices: [{ delta: {}, finish_reason: "tool_calls" }] },
];
const wire = events.map((e) => `data: ${JSON.stringify(e)}\n\n`).join("") + "data: [DONE]\n\n";
// 网络不看语义:整段字节流每 31 字节掐一刀 —— 必然有分片停在 data: 行
// 中间、JSON 字符串中间、甚至"我来"这种多字节字符的字节中间。
const bytes = new TextEncoder().encode(wire);
const chunks = [];
for (let i = 0; i < bytes.length; i += 31) chunks.push(bytes.slice(i, i + 31));
console.log(` 线路上:${events.length + 1} 个事件被切成 ${chunks.length} 个原始分片,比如:`);
const rawPreview = (u8) => JSON.stringify(new TextDecoder("utf-8", { fatal: false }).decode(u8));
console.log(` 分片[0] = ${rawPreview(chunks[0])}`);
console.log(` 分片[1] = ${rawPreview(chunks[1])}`);
async function* fakeBody() {
for (const chunk of chunks) yield chunk;
}
const assembler = createAssembler();
let live = "";
for await (const event of sseJsonEvents(fakeBody())) {
live += assembler.feed(event); // 真实 agent 在这里 process.stdout.write,打字机效果
}
const msg = assembler.message();
console.log(` 实时打印的文本:${JSON.stringify(live)}`);
console.log(` 装配出的 tool_calls(arguments 拼完才 parse):`);
for (const tc of msg.tool_calls) {
console.log(` ${tc.id} → ${tc.function.name}(${JSON.stringify(JSON.parse(tc.function.arguments))})`);
}
// ─── 场景二:中断后的消息序列修复 ────────────────────────────────────────
console.log("\n━━━ 场景二:Ctrl+C 撕裂的消息序列,修复后能继续对话 ━━━");
// 复盘一次真实的中断现场:模型发起了两个工具调用,第一个跑完了,
// 用户在第二个开跑前按了 Ctrl+C —— 而且流是被掐断的,第二个调用的
// arguments 断在 JSON 中间。
const messages = [
{ role: "user", content: "把测试跑一遍,顺便看下 README" },
{
role: "assistant",
content: "好,我先跑测试,再看 README。",
tool_calls: [
{ id: "call_test", type: "function", function: { name: "run_shell", arguments: '{"command":"npm test"}' } },
{ id: "call_read", type: "function", function: { name: "read_file", arguments: '{"path":"READ' } }, // ← 断在半截
],
},
{ role: "tool", tool_call_id: "call_test", content: "命令失败(exit 1):\n1 test failed" },
// ← Ctrl+C 落在这里:call_read 没有 tool 结果。这串 messages 直接发出去,
// OpenAI 兼容后端一律 400(每个 tool_call 必须跟一条 tool 结果消息)。
];
const shape = (msgs) =>
msgs
.map((m) => (m.role === "tool" ? `tool(${m.tool_call_id})` : m.tool_calls ? `assistant+${m.tool_calls.length}calls` : m.role))
.join(" → ");
console.log(` 修复前:${shape(messages)}`);
console.log(` 悬空:call_read 没有 tool 结果;参数断裂:${JSON.stringify(messages[1].tool_calls[1].function.arguments)}`);
const filled = repairDanglingToolCalls(messages);
console.log(` 修复后:${shape(messages)}(回填 ${filled} 条)`);
console.log(` 合成结果:${JSON.stringify(messages.find((m) => m.tool_call_id === "call_read").content)}`);
console.log(` 参数修复:${JSON.stringify(messages[1].tool_calls[1].function.arguments)}`);
console.log(` 再跑一遍修复(应当无操作、幂等):回填 ${repairDanglingToolCalls(messages)} 条`);
console.log(`
结论:
· SSE 分片和事件边界无关 —— 按行缓冲 + TextDecoder(stream) 之后,
掐在任何位置的分片都能装回原样;tool_calls 靠 index 归队,
arguments 是碎 JSON 字符串,拼完才能 parse。
· 中断很容易,中断后还能继续对话才是工程:悬空的 tool_call 回填
合成结果("${INTERRUPT_NOTE}"),
断裂的参数修成 {},消息序列重新配平 —— 下一句话不会撞上 400。
`);
|
loop-budget.mjs#
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
| // 循环预算 —— agent 的防空转看门狗。
//
// 从真实产品 Reina 的 packages/core/src/loop-budget.ts 简化移植,机制一致:
// · 软预算 + 硬顶(4 倍):有进展就自动续期,真正失控才熔断
// · 三个行为探测器:复读机 / 原地踏步 / 连环报错
// · 熔断不是死刑:可恢复的停止先给模型一次"自我纠偏"的机会
//
// 演示阈值调小了方便观察(生产值见 README)。
export class LoopBudget {
constructor({
baseSteps = 12,
hardMaxSteps,
stagnationLimit = 5,
repeatedActionLimit = 4,
consecutiveErrorLimit = 3,
} = {}) {
this.baseSteps = baseSteps;
this.hardMaxSteps = hardMaxSteps ?? baseSteps * 4;
this.stagnationLimit = stagnationLimit;
this.repeatedActionLimit = repeatedActionLimit;
this.consecutiveErrorLimit = consecutiveErrorLimit;
this.seenActions = new Map(); // "工具名:参数指纹" -> 出现次数
this.noProgressTurns = 0;
this.consecutiveErrorTurns = 0;
this.budget = this.baseSteps;
this.turns = 0;
}
canContinue() {
return this.turns < this.budget;
}
/** 每执行完一轮工具调用喂一次。返回 undefined = 继续,返回 stop 对象 = 熔断。
* records: [{ name, input, status: "completed"|"failed", output }] */
recordTurn(records) {
this.turns++;
const counts = records.map((r) => this.#recordAction(r));
const hasProgress = records.some((r, i) => isProgress(r, counts[i]));
const hasRepeated = counts.some((c) => c >= this.repeatedActionLimit);
const onlyErrors = records.length > 0 && records.every((r) => r.status === "failed");
// 两个计数器:有进展就清零,说明 agent 还活着;持续无进展/持续报错才累积。
this.noProgressTurns = hasProgress ? 0 : this.noProgressTurns + 1;
this.consecutiveErrorTurns = onlyErrors ? this.consecutiveErrorTurns + 1 : 0;
if (hasRepeated && !hasProgress) return this.#stop("repeated_action");
if (this.consecutiveErrorTurns >= this.consecutiveErrorLimit) return this.#stop("consecutive_errors");
if (this.noProgressTurns >= this.stagnationLimit) return this.#stop("no_progress");
// 自动续期:有进展、且预算只剩 2 轮,就再给一份 baseSteps(封顶 hardMax)。
// 勤奋的 agent 不该被一刀切的上限打断,失控的 agent 也不该无限烧钱。
if (hasProgress && this.turns >= this.budget - 2 && this.budget < this.hardMaxSteps) {
this.budget = Math.min(this.hardMaxSteps, this.budget + this.baseSteps);
}
return undefined;
}
exhaustedStop() {
return this.#stop(this.budget >= this.hardMaxSteps ? "hard_max_steps" : "max_steps");
}
#recordAction(record) {
// 参数做稳定序列化(key 排序),结构相同的调用无论字段顺序都算同一个动作。
const key = `${record.name}:${stableStringify(record.input)}`;
const count = (this.seenActions.get(key) ?? 0) + 1;
this.seenActions.set(key, count);
return count;
}
#stop(reason) {
return {
reason,
message: MESSAGES[reason],
turnCount: this.turns,
maxSteps: this.budget,
hardMaxSteps: this.hardMaxSteps,
};
}
}
/** 什么算"进展"?——写操作永远算;读操作只有第一次算。
* 第二次跑同一条命令、读同一个文件,世界没有变化,不算进展。 */
function isProgress(record, actionCount) {
if (record.status !== "completed") return false;
if (["write_file", "edit_file"].includes(record.name)) return true;
return Boolean(record.output?.trim()) && actionCount === 1;
}
export const MESSAGES = {
no_progress: "连续多轮没有新进展,暂停。",
repeated_action: "同一个工具动作被反复执行,暂停。",
consecutive_errors: "连续多轮全部报错,暂停。",
max_steps: "达到本轮工具预算,暂停。",
hard_max_steps: "达到硬性上限,强制停止。",
};
/** 行为异常(复读/停滞/连环报错)可以给模型一次自我纠偏的机会;
* 预算耗尽(max_steps 系)说明该歇了,直接交还用户。 */
export function isRecoverable(stop) {
return ["no_progress", "repeated_action", "consecutive_errors"].includes(stop.reason);
}
/** 纠偏 prompt:告诉模型它被暂停的原因和当前状态,并明确指令 ——
* 别重复原动作;先总结、找到卡点、换一条路;实在不行就问用户。 */
export function repairPrompt(stop) {
return [
`自动纠偏触发:${stop.message}`,
`循环状态:原因=${stop.reason},已用 ${stop.turnCount} 轮,预算 ${stop.maxSteps},硬顶 ${stop.hardMaxSteps}。`,
"不要再重复同样的工具调用或失败的命令。先总结目前发生了什么、找出卡点,换一条不同的路。如果任务被阻塞或有歧义,向用户提一个具体的问题,而不是继续空转。",
].join("\n");
}
function stableStringify(value) {
if (value === null || typeof value !== "object") return JSON.stringify(value);
if (Array.isArray(value)) return `[${value.map(stableStringify).join(",")}]`;
return `{${Object.entries(value)
.sort(([a], [b]) => a.localeCompare(b))
.map(([k, v]) => `${JSON.stringify(k)}:${stableStringify(v)}`)
.join(",")}}`;
}
|
stream.mjs#
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
| // 流式与中断 —— 本章的机制模块,零依赖。
//
// 三件事:
// 1. sseJsonEvents:手工解析 OpenAI 兼容的 SSE 流(data: 行、[DONE]、按行缓冲)
// 2. createAssembler:把 delta 分片装配回一条完整的 assistant 消息
// (content 逐段拼接;tool_calls 按 index 聚合,arguments 是碎 JSON 字符串分片)
// 3. repairDanglingToolCalls:中断后修复消息序列 —— 给悬空的 tool_call
// 回填合成结果,会话才能继续(协议要求每个 tool_call 必须有对应的 tool 消息)
//
// 对应真实产品 Reina 的 packages/providers/src/tool-pairing.ts
// (codex 同款的双向配平:悬空 call 合成占位输出,孤儿结果降级为文本)。
/** 逐事件解析 SSE 字节流。body 是任何异步可迭代的字节块序列
* (fetch 的 response.body 就是),每拿到一条 `data: {...}` 就 yield 出解析
* 好的 JSON 对象,遇到 `data: [DONE]` 结束。
*
* 关键点是**按行缓冲**:TCP/代理切分数据从不看语义,一个 chunk 可能停在
* 半行、甚至半个多字节字符的中间 —— 所以字节先过 TextDecoder(stream 模式),
* 文本攒进缓冲区,凑出完整的一行才处理一行。 */
export async function* sseJsonEvents(body) {
const decoder = new TextDecoder();
let buffer = "";
for await (const chunk of body) {
buffer += decoder.decode(chunk, { stream: true });
let newline;
while ((newline = buffer.indexOf("\n")) !== -1) {
const line = buffer.slice(0, newline).replace(/\r$/, "");
buffer = buffer.slice(newline + 1);
// 空行是事件分隔符;": xxx" 开头的是注释行(有些网关拿它当心跳)——都跳过。
if (!line.startsWith("data:")) continue;
const payload = line.slice(5).trim();
if (payload === "[DONE]") return;
yield JSON.parse(payload);
}
}
}
/** delta 装配器:喂进一个个流式事件,最后拿回一条完整的 assistant 消息。
*
* content 好办 —— 字符串逐段拼。tool_calls 阴得多:
* · 一次 delta 可能只带 id,可能只带函数名,也可能只带 arguments 的几个字符;
* · arguments 是被切碎的 JSON 字符串分片 —— 拼完之前 parse 必炸,
* 所以只做 += ,把 parse 留给拼完之后的人;
* · 并行工具调用时多个 call 交错到达,靠 delta 里的 index 归队。 */
export function createAssembler() {
let content = "";
const toolCalls = []; // index -> 聚合中的 tool_call
let finishReason = null;
return {
/** 喂一个 SSE 事件,返回本次新到的文本增量(调用方拿去实时打印)。 */
feed(event) {
const choice = event.choices?.[0];
if (!choice) return ""; // 有些兼容端在最后补一个只带 usage 的空 choices 事件
if (choice.finish_reason) finishReason = choice.finish_reason;
const delta = choice.delta ?? {};
const textDelta = delta.content ?? "";
content += textDelta;
for (const tc of delta.tool_calls ?? []) {
const slot = (toolCalls[tc.index] ??= { id: "", type: "function", function: { name: "", arguments: "" } });
if (tc.id) slot.id = tc.id;
if (tc.function?.name) slot.function.name += tc.function.name;
if (tc.function?.arguments) slot.function.arguments += tc.function.arguments;
}
return textDelta;
},
/** 流结束(或被中断)后取出装配结果。中断时拿到的就是"半截消息"——
* 已经流出来的部分都在,这正是修复函数的输入。 */
message() {
const msg = { role: "assistant", content };
const calls = toolCalls.filter(Boolean);
if (calls.length > 0) msg.tool_calls = calls;
return msg;
},
finishReason: () => finishReason,
};
}
export const INTERRUPT_NOTE = "(用户中断了执行,该工具未运行——不是工具失败,需要时可以重新调用)";
/** 中断后修复消息序列。OpenAI 协议的硬性要求:assistant 消息里的每个
* tool_call,后面都必须跟一条对应 tool_call_id 的 tool 消息 —— 否则下一次
* API 调用直接 400。中断恰好会把序列撕成半截:tool_calls 已经进了历史,
* 工具却没跑(或只跑了一半的批次)。
*
* 修复动作有两个:
* 1. 给每个悬空的 tool_call 回填一条合成 tool 结果(文案写明"用户中断、
* 未运行",防止模型误以为工具失败而盲目重试);
* 2. arguments 可能断在 JSON 中间(流被掐断时最后一个分片没到齐),
* 断裂的参数修成 "{}" —— 挑剔的后端会校验历史里的这段字符串。
*
* 返回回填的条数。对完整的序列是无操作,随便多跑几遍都安全(幂等)。 */
export function repairDanglingToolCalls(messages, note = INTERRUPT_NOTE) {
const answered = new Set(messages.filter((m) => m.role === "tool").map((m) => m.tool_call_id));
let repaired = 0;
for (let i = messages.length - 1; i >= 0; i--) {
const msg = messages[i];
if (msg.role !== "assistant" || !msg.tool_calls?.length) continue;
for (const tc of msg.tool_calls) {
try {
JSON.parse(tc.function.arguments || "{}");
} catch {
tc.function.arguments = "{}";
}
}
const missing = msg.tool_calls.filter((tc) => !answered.has(tc.id));
if (missing.length === 0) continue;
// 回填插在 assistant 消息紧后面,和真实 tool 结果保持同一块 —— 有些后端
// 要求 tool 消息紧跟发起它的 assistant 消息,中间不能夹别的角色。
messages.splice(i + 1, 0, ...missing.map((tc) => ({ role: "tool", tool_call_id: tc.id, content: note })));
repaired += missing.length;
}
return repaired;
}
|
① SSE 解析:按行缓冲,而不是按 chunk 处理#
SSE(Server-Sent Events)是流式输出的传输方式:stream: true 时服务端保持连接打开,把回答切成小片逐个推送,每片是文本流里的一行:
1
2
3
4
5
| data: {"choices":[{"delta":{"content":"我来"}}]}
data: {"choices":[{"delta":{"content":"查一下"}}]}
data: [DONE]
|
data: 开头是数据行,空行是分隔符,data: [DONE] 表示结束。看起来逐行 parse 即可,但你收到的单位不是"行”:网络传输切分数据时不管语义,一个 chunk 可能停在 data: {"cho 中间,甚至停在一个 UTF-8 多字节字符中间。所以必须按行缓冲,凑齐一行才处理一行(见上文内嵌的 stream.mjs 源码):
1
2
3
4
5
6
7
8
| buffer += decoder.decode(chunk, { stream: true }); // stream 模式:不完整的多字节字符先保留
let newline;
while ((newline = buffer.indexOf("\n")) !== -1) { // 凑齐完整的一行才处理一行
const line = buffer.slice(0, newline).replace(/\r$/, "");
buffer = buffer.slice(newline + 1);
if (!line.startsWith("data:")) continue; // 空行、": 心跳" 注释行,都跳过
// ...
}
|
文本增量直接拼接即可。tool_calls 的增量是被切碎的 JSON 字符串:第一片带 id 和函数名,后续片只带参数的几个字符;并行调用时多个 call 的分片交错到达,靠 index 归位:
1
2
3
4
5
6
| for (const tc of delta.tool_calls ?? []) {
const slot = (toolCalls[tc.index] ??= { id: "", type: "function", function: { name: "", arguments: "" } });
if (tc.id) slot.id = tc.id;
if (tc.function?.name) slot.function.name += tc.function.name;
if (tc.function?.arguments) slot.function.arguments += tc.function.arguments;
}
|
常见错误:每收到一片就 JSON.parse——必然失败,{"comm 不是合法 JSON。装配阶段只拼接,parse 留到拼完之后。
③ 中断信号:一个 AbortController 贯穿 HTTP 层与工具循环#
中断不能只设布尔标志——正在传输的 HTTP 流不会检查标志。把 AbortController 的 signal 传给 fetch,abort 时连接立即断开;断开会让读流代码抛错,确认是主动中断(signal.aborted)就吞掉错误,已装配的半截消息照常返回——用户看到的内容必须留在历史里,否则模型下一轮缺上下文。
中断也可能落在两次工具执行之间,每次派发前再检查:
1
2
3
4
| for (const call of msg.tool_calls) {
if (controller.signal.aborted) break; // 剩余调用不跑,悬空部分交给修复函数
// ...
}
|
Ctrl+C 的策略:第一次中断本轮,第二次退出进程——“停下这一轮"和"退出程序"是两个意图,分开处理(readline 监听细节见文末)。
残缺序列有三种处理方式:
| 做法 | 结果 |
|---|
| 把半截 assistant 消息整个丢掉 | 不会 400,但用户看到的那半截回答不在历史里,下一轮模型缺失上下文 |
| 原样保留,直接发 | 400 |
| 保留 + 回填合成 tool 结果 | 序列配平,会话继续 |
回填就是给每个没有结果的 tool_call 补一条假的 tool 消息。文案是写给模型看的界面(s02),要说清两点:
1
| (用户中断了执行,该工具未运行——不是工具失败,需要时可以重新调用)
|
说"不是失败”,模型不会误判为工具故障而绕路;说"可以重新调用”,用户说"继续"时它知道从哪接。顺带把断在 JSON 中间的参数改为 {}(部分后端会校验它)。修复函数幂等——对完好序列无操作,重复执行安全。
运行:#
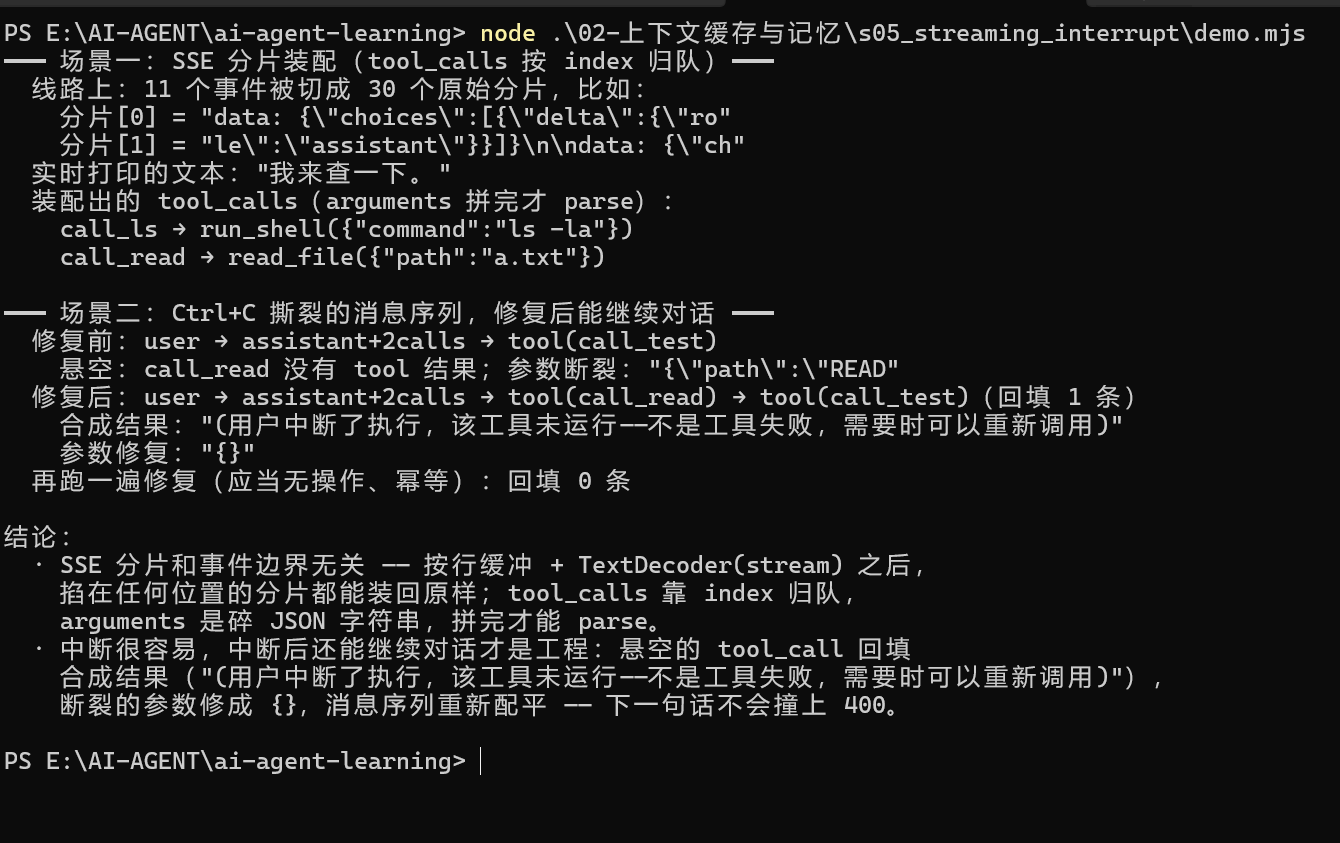
node .\02-上下文缓存与记忆\s05_streaming_interrupt\demo.mjs
中断有时过重——用户只是想补一句"顺便用 –verbose 跑",不想丢弃正在生成的回答。codex 和 Reina 都支持 steer:不打断当前流,把用户插话排队,等本轮迭代提交后作为下一条 user 消息注入。给本章 agent 加上这个能力:轮次进行中输入的文字不触发中断、进入队列(提示:难点在插入位置——工具结果和插话的先后顺序,想想为什么插在 tool 结果之后比之前安全)。
思考题:合成结果的文案,"(用户中断了执行,该工具未运行)" 与 codex 风格的单词 “aborted”,各会把模型引向什么行为?构造一个"中断后用户说『继续』“的场景,推演两种文案下模型的下一步动作差异。
构造场景
用户说"运行测试并读取 README”。模型发出两个工具调用 [call_test → npm test, call_read → read_file README],中途 Ctrl+C 落在 call_test 跑完后、call_read 执行前。修复后历史是:
1
2
3
4
5
| user: 运行测试并读取 README
assistant: tool_calls [call_test, call_read]
tool: (call_test 结果 —— npm test 实际跑完了)
tool: (call_read 的合成结果 ← 两种文案在这里分叉)
user: 继续
|
推演两种文案下模型的下一步
长文案(“未运行 / 不是失败 / 可以重新调用”):
- 模型读到三块明确信息:测试跑完了(结果在)、README 没跑、不是失败。
- 用户说"继续" → 模型确定地知道缺的是哪一环:call_read 没跑过 → 直接重新调用 read_file README → 然后汇总。恢复路径是确定的、可预期的。
codex 的 “aborted”:
- 模型只知道"这个调用被中止了",但不知道:跑了没有?算不算失败?要不要重跑?
- 用户说"继续" → 模型开始猜:
- 猜对了:重新 read README(结果一样,但靠的是推理不是指导);
- 猜错了:把 aborted 当"出错了" → 触发它的失败启发式(“换一条路”),可能把 npm test 也重跑一遍(“保险起见”)——如果测试有副作用,就是白白浪费甚至出错;
- 或者拿不准 → 反问"您要我继续做什么?"(摩擦,打断流畅性)。
结论
| 维度 | 长文案 | “aborted” |
|---|
| “继续"后的行为 | 确定地续上(重调中断的调用) | 靠猜,可能重跑错的/反问 |
| 防"误判为失败” | ✅ 明确说"不是失败" | ❌ 可能触发失败启发式、绕路 |
| 防"以为跑过了" | ✅ 明确说"未运行" | ❌ 可能以为已跑完、跳过 |
| token 成本 / 简洁 | 贵一点 | 便宜 |
| 文案污染模型语气 | 可能被模型学舌 | 基本不会 |
一句话:长文案是"把恢复路径写进协议",“aborted” 是把决策交给模型的猜测。长文案牺牲一点 token,换"继续"这个高频操作的高确定性;codex 选短词,是因为它的产品里修复文案极少被模型真正"用到",它赌的是模型自己会推断——这是产品取舍,没有对错,看你把"继续"这种场景当高频还是低频。
练习 1 的实现思路(steer)
机制一:并发读输入 + 队列
放弃 rl.question,改用 rl.on(“line”) 常驻监听,再配一个"空闲等待"的 Promise:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
| let queue = []; // 插话队列
let inTurn = false; // 是否有轮次在跑
let idleResolver = null;
rl.on("line", (line) => {
line = line.trim();
if (!line) return;
if (inTurn) {
queue.push(line); // 轮次进行中 → 排队,不打断
console.log("\x1b[36m(已排队,将在当前工具执行完后处理)\x1b[0m");
} else if (idleResolver) {
idleResolver(line); // 空闲 → 正常走下一轮
}
});
function askIdle() {
return new Promise((resolve) => { idleResolver = resolve; });
}
|
主循环改成:先看队列有没有货,有就直接起一轮;没有才等键盘:
1
2
3
4
5
6
7
8
| while (true) {
const line = queue.length ? queue.shift() : (await askIdle());
if (!line) continue;
inTurn = true;
messages.push({ role: "user", content: line });
await runTurn(messages);
inTurn = false;
}
|
这样 turn 跑着的时候用户输入的文字会进 queue,一个字节都不打扰正在生成的回答。
机制二:安全点注入(核心难点,提示里的"为什么"在这)
队列有了,关键问题是插到 messages 的哪个位置。先看一轮迭代提交后消息序列长什么样:
1
2
3
4
| assistant: tool_calls [call_A, call_B] ← 本轮迭代
tool: (call_A 结果)
tool: (call_B 结果)
↑ 插话要插在这里,而不是更早
|
为什么插在 tool 结果之后才安全?
① 协议层:tool_call 配对是硬约束。这一章整章都在跟这个错误搏斗——协议要求 assistant 消息里的每个 tool_call,必须紧跟对应 id 的 tool 消息,中间不能夹别的角色(stream.mjs 里修复函数都专门注释了"有些后端要求 tool 消息紧跟发起它的 assistant 消息")。如果你把插话插成这样:
1
2
3
| assistant: tool_calls [call_A] ← 还没执行
user: "顺便用 --verbose 跑" ← 插在这里 ← ❌
tool: (call_A 结果)
|
下一次 chat() 发出去,assistant 的 tool_calls 和它的 tool 结果之间隔了一条 user 消息 → 协议破坏 → 400。你等于亲手制造了本章前半段刚修好的那个 bug。
② 语义层:模型得先看到结果,才能听懂插话。插在 tool 结果之前,模型回应"顺便用 –verbose 跑"时还不知道 call_A 的结果——比如 npm test 明明已经失败了,它却可能拿着插话去"继续跑测试"。先给结果、再给插话,模型才能带着完整上下文决定"哦,测试失败了,那我用 –verbose 重跑看细节"。
所以安全点就是当前迭代的所有 tool 结果都入列之后:
1
2
| // 工具批次执行完、全部 tool 结果入列之后 —— 此刻 assistant+tool 配对完整
while (queue.length) messages.push({ role: "user", content: queue.shift() });
|
放在 runTurn 里 budget.recordTurn(records) 前后都行,关键是在这一批 tool 结果 push 完之后、下一次 chat() 之前。
边界情况(想清楚就是真懂了)
- 模型在流式输出、还没发工具调用时插话 → 没有 tool 结果可等。那就等这轮迭代结束:如果它发出 tool_calls,插在该批结果后;如果它直接给最终答案(无 tool_calls),runTurn 返回,主循环里的 queue.length ? queue.shift() 会立刻把它当下一轮的开场。两条路都不会破坏配对。
- 插话排队时不打断 → 你代码里 dispatch 是同步的(execSync),line 事件只在 await 缝隙里触发,天然安全。
- Ctrl+C 和 steer 并存 → 两者意图不同,分开处理:Ctrl+C 仍走 abort,正常输入进队列。
与真实产品对照(延伸阅读)#
Reina(本系列对照的生产级 agent)的对应机制在 packages/providers/src/tool-pairing.ts:normalizeToolPairing 做双向配平——除了本章的"悬空 call 合成占位输出"(合成文案同样说明"可能被中断丢失,需要时重跑"),还处理反方向的"孤儿结果":一条 tool 结果找不到发起它的 call,同样会被后端拒收(“No tool call found for function call output with call_id …")。codex 的做法是把孤儿直接丢弃;Reina 把它降级为普通文本消息——因为 Reina 的孤儿消息里常含有真实信息,直接丢弃会损失内容。这套修复在生产里静默执行,但 REINA_STRICT_TOOL_PAIRING=1 时会直接抛错——配平失守说明上游某个不变量被破坏,开发环境里应当尽早暴露。
引擎侧的中断在 packages/core/src/engine.ts:interrupt() 除了 abort,还会立刻换上一个新的 AbortController 并清空待处理队列——这曾引出一个隐蔽 bug:换新之后,工具批次里尚未执行的调用读到的是新 controller 的未中断 signal,会照常执行;所以 Reina 在批次内每次派发前检查的是 session.interrupted 标志位,而不是 signal。另外中断不只有 Ctrl+C 一种:进程崩溃、断电也是中断——recoverInterruptedTurn() 在重新加载会话时检测"卡在 running 状态的工具调用”,统一标记失败并回填错误文案。这依赖会话落盘,见 s08。
上下文压缩#
实现压缩器
把旧消息换成摘要。但压缩自带一个隐蔽问题:摘要是模型写的,转述必然走样——第一次压缩,你的指令变成"用户在重构日期工具函数";再压一次,变成"用户在优化项目代码"——最后 agent 停下来问你想做什么。它没报错,只是把指令转述丢了。
解决方案#
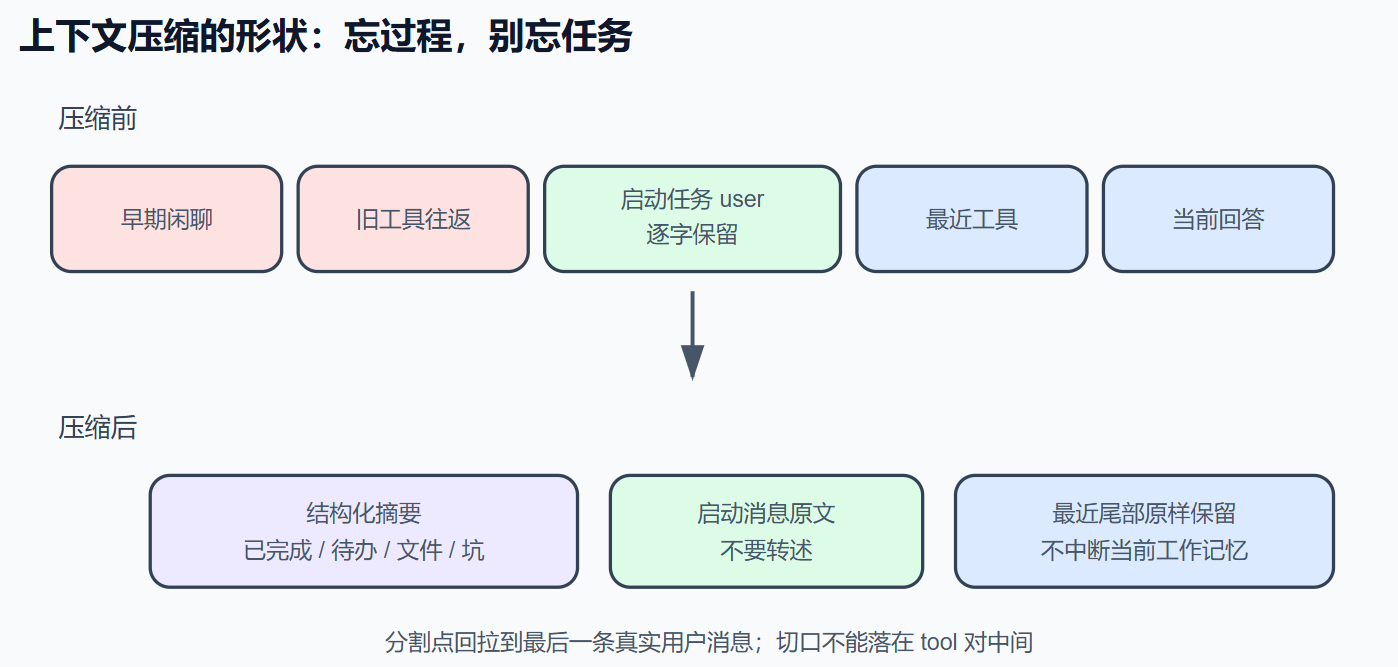
压缩不是"全部换成摘要":用模型生成的结构化摘要替换中段历史,同时逐字保留启动本轮任务的用户消息、原样保留最近的尾部(模型正在用的工作记忆)。既然转述会走样,有些内容必须逐字保留过压缩。
触发时机用服务商报告的 usage 判断,不自己数 token;摘要让模型按栏目填写,不是笼统总结;摘要模型调用失败时降级为纯字符串处理的提取式摘要——压缩不能因摘要失败而毁掉会话。
实现:#
agent.mjs#
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
218
219
220
221
222
223
224
225
226
227
228
229
230
231
232
233
234
235
236
237
238
239
240
241
242
243
244
245
246
247
248
249
250
251
252
253
254
255
256
257
258
259
260
261
262
263
264
265
266
267
268
269
270
271
272
273
274
275
276
277
278
279
280
281
282
283
284
285
| #!/usr/bin/env node
// s06 —— 上下文压缩:s03 的 agent(工具注册表 + 看门狗)+ 压缩器。
//
// 新增的全部内容:
// · chat() 顺带返回服务商的 usage —— 触发判定的唯一依据
// · 每轮工具执行结束后 maybeCompact():超阈值就地压缩 messages
// · 摘要调用失败自动降级为提取式摘要(compaction.mjs 内部兜底)
//
// 运行方式与 s03 相同:AGENT_API_KEY=sk-xxx node agent.mjs
import readline from "node:readline/promises";
import { execSync } from "node:child_process";
import { readFileSync, writeFileSync, mkdirSync } from "node:fs";
import path from "node:path";
import { LoopBudget, isRecoverable, repairPrompt } from "./loop-budget.mjs";
import { shouldCompact, compactMessages, SUMMARY_PROMPT } from "./compaction.mjs";
const BASE_URL = process.env.AGENT_BASE_URL ?? "https://api.deepseek.com/v1";
const API_KEY = process.env.AGENT_API_KEY;
const MODEL = process.env.AGENT_MODEL ?? "deepseek-chat";
// 模型窗口没有任何 API 能查询,只能自己配(Reina 也是配在 models.json 里)。
// DeepSeek 128k;换模型记得改,配大了会在真窗口边界撞 "context too long"。
const CONTEXT_WINDOW = Number(process.env.AGENT_CONTEXT_WINDOW ?? 128_000);
const COMPACT_PERCENT = Number(process.env.AGENT_COMPACT_PERCENT ?? 75);
if (!API_KEY) {
console.error("缺少 AGENT_API_KEY。任何 OpenAI 兼容的 key 都行(DeepSeek / Kimi / GLM / OpenRouter / 本地 Ollama)。");
process.exit(1);
}
const SYSTEM = `你是一个运行在用户终端里的编程助手。
优先用专用工具(read_file / write_file / edit_file)操作文件;run_shell 用于其余一切。
先观察真实世界再行动,不要凭空猜测文件内容。
当前目录:${process.cwd()}
操作系统:${process.platform}`;
// ─── 工具注册表(与 s03 相同)─────────────────────────────────────────────
const REGISTRY = {
run_shell: {
description: "在用户的终端里执行一条 shell 命令,返回 stdout 和 stderr。",
parameters: {
type: "object",
properties: { command: { type: "string", description: "要执行的命令" } },
required: ["command"],
},
handler: ({ command }) => {
console.log(`\x1b[33m $ ${command}\x1b[0m`);
try {
const out = execSync(command, {
encoding: "utf8",
timeout: 30_000,
maxBuffer: 1024 * 1024,
stdio: ["ignore", "pipe", "pipe"],
});
return out.trim() || "(命令执行成功,无输出)";
} catch (err) {
return `命令失败(exit ${err.status ?? "?"}):\n${err.stdout ?? ""}${err.stderr ?? err.message}`;
}
},
},
read_file: {
description: "读取一个文本文件,返回带行号的内容。",
parameters: {
type: "object",
properties: { path: { type: "string", description: "文件路径(相对或绝对)" } },
required: ["path"],
},
handler: ({ path: p }) => {
console.log(`\x1b[33m read ${p}\x1b[0m`);
const text = readFileSync(p, "utf8");
const CAP = 50_000;
const body = text.length > CAP ? text.slice(0, CAP) + `\n…(截断,共 ${text.length} 字符)` : text;
return body
.split("\n")
.map((line, i) => `${String(i + 1).padStart(4)}\t${line}`)
.join("\n");
},
},
write_file: {
description: "写入一个文件(整体覆盖)。父目录不存在时自动创建。",
parameters: {
type: "object",
properties: {
path: { type: "string", description: "文件路径" },
content: { type: "string", description: "完整的文件内容" },
},
required: ["path", "content"],
},
handler: ({ path: p, content }) => {
console.log(`\x1b[33m write ${p} (${content.length} 字符)\x1b[0m`);
mkdirSync(path.dirname(path.resolve(p)), { recursive: true });
writeFileSync(p, content);
return `已写入 ${p}`;
},
},
edit_file: {
description:
"对文件做一次精确替换。old_string 必须在文件中出现且仅出现一次(带上足够的上下文来保证唯一),否则会失败。",
parameters: {
type: "object",
properties: {
path: { type: "string", description: "文件路径" },
old_string: { type: "string", description: "要被替换的原文(必须唯一匹配)" },
new_string: { type: "string", description: "替换成的新文本" },
},
required: ["path", "old_string", "new_string"],
},
handler: ({ path: p, old_string, new_string }) => {
console.log(`\x1b[33m edit ${p}\x1b[0m`);
const text = readFileSync(p, "utf8");
const first = text.indexOf(old_string);
if (first === -1) return `编辑失败:old_string 在 ${p} 中找不到。请先 read_file 确认原文。`;
if (text.indexOf(old_string, first + 1) !== -1)
return `编辑失败:old_string 在 ${p} 中出现多次。请带上更多上下文让它唯一。`;
// 不能用 text.replace(old, new):new_string 里的 $$ / $& 会被 JS 当替换模式展开,静默写坏文件。
writeFileSync(p, text.slice(0, first) + new_string + text.slice(first + old_string.length));
return `已编辑 ${p}`;
},
},
};
const TOOLS = Object.entries(REGISTRY).map(([name, t]) => ({
type: "function",
function: { name, description: t.description, parameters: t.parameters },
}));
const FAILURE_RE = /^(命令失败|编辑失败|工具执行出错|未知工具|工具参数)/;
function dispatch(call) {
const tool = REGISTRY[call.function.name];
if (!tool) return `未知工具:${call.function.name}`;
let args;
try {
args = JSON.parse(call.function.arguments || "{}");
} catch (err) {
return `工具参数不是合法 JSON:${err.message}`;
}
try {
return tool.handler(args);
} catch (err) {
return `工具执行出错:${err.message}`;
}
}
// ─── 模型调用:现在连 usage 一起带回来 ───────────────────────────────────
async function chat(messages) {
const res = await fetch(`${BASE_URL}/chat/completions`, {
method: "POST",
headers: {
"content-type": "application/json",
authorization: `Bearer ${API_KEY}`,
},
body: JSON.stringify({
model: MODEL,
messages: [{ role: "system", content: SYSTEM }, ...messages],
tools: TOOLS,
}),
});
if (!res.ok) throw new Error(`API ${res.status}:${await res.text()}`);
const data = await res.json();
// usage 是服务商的账本:prompt_tokens / completion_tokens / total_tokens。
// 压缩触发只信它——本地估算对不上服务商的 tokenizer。
return { message: data.choices[0].message, usage: data.usage };
}
// 摘要也是一次模型调用——但不带 tools(摘要不许干活),system 换成结构化
// 摘要指令。任何失败直接 throw,由 compactMessages 降级为提取式摘要。
async function summarizeViaModel(middleText) {
const res = await fetch(`${BASE_URL}/chat/completions`, {
method: "POST",
headers: {
"content-type": "application/json",
authorization: `Bearer ${API_KEY}`,
},
body: JSON.stringify({
model: MODEL,
messages: [
{ role: "system", content: SUMMARY_PROMPT },
{ role: "user", content: `以下是即将被压缩掉的对话段(从旧到新):\n\n${middleText}\n\n现在按五个小节输出摘要。` },
],
}),
});
if (!res.ok) throw new Error(`摘要调用失败:API ${res.status}`);
const data = await res.json();
return data.choices[0].message.content;
}
// ─── 每轮结束检查:超阈值就地压缩 ────────────────────────────────────────
async function maybeCompact(messages, usage) {
const decision = shouldCompact({
usage,
contextWindow: CONTEXT_WINDOW,
triggerPercent: COMPACT_PERCENT,
messageCount: messages.length,
});
if (!decision.compact) return;
console.log(`\n\x1b[36m🗜️ 触发压缩:${decision.why}\x1b[0m`);
const result = await compactMessages(messages, { summarize: summarizeViaModel });
if (!result.compacted) {
console.log("\x1b[36m 可压的前缀太小,本次跳过。\x1b[0m");
return;
}
// 就地替换:外层循环和本函数共享同一个数组引用,不能换新数组。
messages.splice(0, messages.length, ...result.messages);
console.log(
`\x1b[36m🗜️ 压缩完成:压掉 ${result.dropped} 条${result.degraded ? "(摘要降级为提取式)" : ""},现存 ${messages.length} 条。\x1b[0m`,
);
}
// ─── 主循环:s03 原样 + 每轮结束的压缩检查 ───────────────────────────────
async function runTurn(messages) {
const budget = new LoopBudget({ baseSteps: 12 });
let repaired = false;
while (true) {
if (!budget.canContinue()) {
const stop = budget.exhaustedStop();
console.log(`\n\x1b[31m⛔ ${stop.message}(第 ${stop.turnCount} 轮)\x1b[0m`);
return;
}
const { message: msg, usage } = await chat(messages);
messages.push(msg);
if (msg.content) console.log(`\n${msg.content}`);
if (!msg.tool_calls?.length) {
await maybeCompact(messages, usage); // 纯文本收尾的轮次也要检查
return;
}
const records = [];
for (const call of msg.tool_calls) {
const output = dispatch(call);
messages.push({ role: "tool", tool_call_id: call.id, content: output });
let input = {};
try {
input = JSON.parse(call.function.arguments || "{}");
} catch { /* 坏参数已作为失败回填 */ }
records.push({
name: call.function.name,
input,
status: FAILURE_RE.test(output) ? "failed" : "completed",
output,
});
}
// 每轮结束检查触发:此刻工具结果刚落地,是上下文长胖最快的时刻。
// usage 来自本轮响应,等下一轮再看它就是旧账了。
await maybeCompact(messages, usage);
const stop = budget.recordTurn(records);
if (!stop) continue;
if (isRecoverable(stop) && !repaired) {
repaired = true;
console.log(`\n\x1b[35m🟡 看门狗触发(${stop.reason}),注入纠偏 prompt…\x1b[0m`);
messages.push({ role: "user", content: repairPrompt(stop) });
continue;
}
console.log(`\n\x1b[31m⛔ ${stop.message}(reason=${stop.reason},第 ${stop.turnCount} 轮)\x1b[0m`);
return;
}
}
const rl = readline.createInterface({ input: process.stdin, output: process.stdout });
const messages = [];
console.log(
`s06 agent 已上线(${MODEL},窗口 ${CONTEXT_WINDOW},${COMPACT_PERCENT}% 触发压缩)。工具:${Object.keys(REGISTRY).join("、")}。Ctrl+C 退出。`,
);
while (true) {
const line = (await rl.question("\n你> ")).trim();
if (!line) continue;
messages.push({ role: "user", content: line });
await runTurn(messages);
}
|
compaction.mjs#
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
| // 上下文压缩 —— 让 agent 忘掉过程,但绝不忘掉任务。
//
// 从真实产品 Reina 的 packages/core/src/compaction.ts 简化移植,机制一致:
// · 触发:用服务商返回的 usage 对照模型窗口,不做本地估算
// · 切片:三段式 [被压缩的中段] + [启动任务的用户消息,逐字保留] + [最近尾部]
// · 摘要:结构化 prompt(不是"总结一下"),失败时降级为提取式摘要
// · 铁律:压缩绝不能因为压缩失败而毁掉会话
// ─── ① 触发决策:信服务商的账本,不信自己的估算 ───────────────────────────
//
// 本地数 token 对不上服务商的 tokenizer(中文误差尤其大,轻松差出 15%+),
// 估少了会在真正的窗口边界撞出 "context too long"。上一次 API 响应的
// usage 是服务商亲口报的数——它说多少就是多少。
// total_tokens = prompt + completion ≈ 下一轮请求要背的全部历史。
export function shouldCompact({ usage, contextWindow, triggerPercent = 75, messageCount, minMessages = 12 }) {
if (!usage) return { compact: false, why: "还没有任何 API 响应,无从判断" };
if (messageCount < minMessages) {
return { compact: false, why: `消息太少(${messageCount} < ${minMessages}),压了也腾不出几个 token` };
}
const used = usage.total_tokens ?? (usage.prompt_tokens ?? 0) + (usage.completion_tokens ?? 0);
const threshold = Math.floor((contextWindow * triggerPercent) / 100);
if (used < threshold) {
return { compact: false, why: `${used} / ${contextWindow} tokens(阈值 ${threshold}),还有余量`, used, threshold };
}
return { compact: true, why: `${used} tokens 已超过阈值 ${threshold}(窗口的 ${triggerPercent}%)`, used, threshold };
}
// ─── ② 切片决策:切哪里,比怎么摘要更重要 ─────────────────────────────────
//
// 返回分割点 keepFrom:messages[0, keepFrom) 被压缩,messages[keepFrom, ∞) 原样保留。
// 返回 0 = 不值得压。
//
// 两条规则,一条语法约束:
// a) 尾部至少保留 keepRecent 条——最近的工具结果是模型正在用的工作记忆。
// b) 分割点回拉到最后一条真实用户消息(role === "user"),让"用户到底让我
// 干嘛"逐字活过压缩。长任务里这条消息往往在几十条工具结果之前——不回拉,
// 它就会被摘要转述,而转述必然走样(Reina 真实修过的坑,见 README)。
// 注意"真实"二字:看门狗的纠偏 prompt、上一次压缩的摘要,也都是
// role:"user" 塞进历史的——锚点若停在它们身上,真正的启动指令照样被
// 转述丢失。所以要按已知前缀把合成消息排除掉。
// 回拉有上限(maxAnchorChars):保留区太大,压缩就腾不出空间了。
// c) 语法约束:OpenAI 格式里 role:"tool" 消息必须紧跟它的 assistant
// tool_calls 消息,切口不能落在一对中间,否则下一次请求直接 400。
// 循环自己塞进历史的 role:"user" 消息,都以这些前缀开头(见 compactMessages
// 和 loop-budget 的 repairPrompt)——它们不是"用户让我干嘛",不能当锚点。
const SYNTHETIC_USER_PREFIXES = ["[上下文压缩]", "自动纠偏触发:"];
const isRealUser = (m) =>
m.role === "user" && !SYNTHETIC_USER_PREFIXES.some((p) => String(m.content ?? "").startsWith(p));
export function compactSplitIndex(messages, { keepRecent = 8, maxAnchorChars = 40_000 } = {}) {
if (messages.length <= keepRecent) return 0;
let keepFrom = messages.length - keepRecent;
const lastUser = messages.findLastIndex(isRealUser);
if (lastUser >= 0 && lastUser < keepFrom) {
const anchoredChars = charsOf(messages.slice(lastUser));
if (anchoredChars <= maxAnchorChars) keepFrom = lastUser;
// 超限就不回拉——此时靠摘要 prompt 里"逐字引用用户原话"的条款兜底。
}
// 切口修正:不能让保留区以孤儿 tool 消息开头。向前多保留几条,
// 直到把 tool 消息和它的 assistant tool_calls 划进同一侧。
while (keepFrom > 0 && messages[keepFrom].role === "tool") keepFrom--;
if (keepFrom <= 1) return 0; // 能压的太少,白白多花一次摘要调用
return keepFrom;
}
// ─── ③ 摘要 prompt:结构化,不是"总结一下" ────────────────────────────────
//
// "总结一下"得到的是一段抒情散文,丢的恰好是接续任务最需要的硬信息。
// 逼模型按栏目填表,每一栏都对应"压缩后第一轮"会用到的东西。
// 第 1 栏的"逐字引用"是对切片规则 b) 的双保险:即使启动消息因超长
// 没能逐字保留,原话也还在摘要里。
export const SUMMARY_PROMPT = `你的任务是把一段即将被丢弃的对话压缩成结构化摘要。这份摘要是后续对话仅存的记忆,宁可啰嗦不可遗漏。只输出纯文本,不要调用任何工具。
必须包含以下小节:
1. 任务目标:用户让你做什么。逐字引用用户原话,禁止转述。
2. 已完成:做了哪些事、各自的结论。
3. 未完成 / 待办:接下来该做什么,按优先级排。
4. 涉及的文件与关键命令:完整路径和完整命令,逐字保留。
5. 关键决定与踩过的坑:为什么选了这条路,哪些路已被证明走不通。`;
// 被压缩的中段可能含 tool 消息和 assistant tool_calls——摘要请求不带 tools
// 参数,部分服务商会拒收这些结构。统一拍平成带标签的纯文本(Reina 的
// toSummarySourceMessages 同款处理),顺带把超长工具输出截到摘要够用的长度。
export function toSummarySource(middle) {
const lines = [];
for (const m of middle) {
if (m.role === "tool") {
lines.push(`[工具结果] ${clip(m.content, 1500)}`);
} else if (m.role === "assistant") {
if (m.content) lines.push(`[assistant] ${clip(m.content, 1500)}`);
for (const call of m.tool_calls ?? []) {
lines.push(`[assistant 调用工具] ${call.function.name}(${clip(call.function.arguments, 300)})`);
}
} else {
lines.push(`[${m.role}] ${clip(m.content, 2000)}`);
}
}
return lines.join("\n");
}
// ─── ④ 降级路径:摘要死了,会话不能陪葬 ───────────────────────────────────
//
// 摘要要调一次模型——而模型调用什么错都可能出(限流、超时、断网)。
// 此刻会话已经贴着窗口上限,"下一轮再试"往往等不起。提取式摘要不聪明,
// 但零依赖、永不失败:有损的记忆也比崩掉的会话强。
export function extractiveSummary(middle) {
const lines = ["(自动降级:摘要模型调用失败,以下为逐条提取的对话骨架)"];
for (const m of middle) {
if (m.role === "tool") lines.push(`- 工具结果: ${clip(oneLine(m.content), 160)}`);
else if (m.role === "assistant" && m.tool_calls?.length) {
lines.push(`- assistant 调用: ${m.tool_calls.map((c) => c.function.name).join("、")}`);
} else if (m.content) lines.push(`- ${m.role}: ${clip(oneLine(m.content), 240)}`);
}
return lines.join("\n");
}
// ─── 组装:执行一次压缩 ──────────────────────────────────────────────────
//
// summarize(middleText) 是调用方注入的异步函数(真 agent 里调 API,
// demo 里用替身)。返回新的 messages 数组,形状:
// [摘要消息] + [保留尾部(以启动任务的用户消息开头,逐字未动)]
export async function compactMessages(messages, { summarize, keepRecent = 8, maxAnchorChars = 40_000 } = {}) {
const keepFrom = compactSplitIndex(messages, { keepRecent, maxAnchorChars });
if (keepFrom <= 0) return { compacted: false, messages };
const middle = messages.slice(0, keepFrom);
const tail = messages.slice(keepFrom);
let summary;
let degraded = false;
try {
summary = (await summarize(toSummarySource(middle)))?.trim();
if (!summary) throw new Error("摘要为空");
} catch {
degraded = true;
summary = extractiveSummary(middle);
}
const summaryMessage = {
role: "user",
content: `[上下文压缩] 更早的 ${middle.length} 条对话已被压缩,以下摘要是它们仅存的记忆:\n\n${summary}\n\n从中断处直接继续任务。不要复述摘要,不要重新自我介绍。`,
};
return { compacted: true, messages: [summaryMessage, ...tail], dropped: middle.length, degraded, summary };
}
// ─── 小工具 ──────────────────────────────────────────────────────────────
function charsOf(messages) {
return messages.reduce((n, m) => n + (m.content?.length ?? 0), 0);
}
function clip(text, max) {
if (typeof text !== "string") return "";
return text.length <= max ? text : `${text.slice(0, max)}…(截断)`;
}
function oneLine(text) {
return String(text ?? "").replace(/\s+/g, " ").trim();
}
|
demo.mjs#
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
| #!/usr/bin/env node
// s06 免 key 演示 —— 伪造一段长对话,看压缩器怎么做决定:
// 场景一:触发判定(信 usage,不信估算)
// 场景二:切片决策 + 结构化摘要(摘要模型用替身,不调 API)
// 场景三:摘要调用失败 → 提取式降级,会话不陪葬
// 场景四:回退/分支后,压缩产物(摘要)是丢是留
//
// 运行:node s06_compaction/demo.mjs
import { shouldCompact, compactSplitIndex, compactMessages } from "./compaction.mjs";
// ─── 伪造一段长会话 ──────────────────────────────────────────────────────
// 形状刻意贴近真实:先有一段"上一个任务"的往返,然后用户发出当前任务
// (启动消息),后面跟一长串 assistant(tool_calls) / tool 交替。
const LAUNCH = "帮我把 utils/date.js 里的 formatDate 改成支持时区参数 tz,默认 UTC;改完跑 npm test,把挂掉的用例也修好。";
let seq = 0;
function toolRound(name, args, output) {
const id = `c${++seq}`;
return [
{ role: "assistant", content: "", tool_calls: [{ id, type: "function", function: { name, arguments: JSON.stringify(args) } }] },
{ role: "tool", tool_call_id: id, content: output },
];
}
const messages = [
// ── 上一个任务:已经完结,是最该被压缩的部分 ──
{ role: "user", content: "这个仓库的测试是怎么组织的?大概讲讲。" },
...toolRound("run_shell", { command: "ls tests" }, "date.test.js\nhttp.test.js\nutils.test.js\n" + "fixture-….json\n".repeat(40)),
...toolRound("read_file", { path: "package.json" }, ' 1\t{ "scripts": { "test": "node --test tests/" } }\n' + " …\n".repeat(50)),
{ role: "assistant", content: "测试用 node --test 跑 tests/ 目录,按模块分文件,fixture 放同目录 JSON。……(此处省略三段介绍)" },
// ── 当前任务:启动消息 + 10 轮工具往返 ──
{ role: "user", content: LAUNCH },
...toolRound("run_shell", { command: "rg -n formatDate src utils" }, "utils/date.js:12: export function formatDate(ts) {\ntests/date.test.js:8: formatDate(0)"),
...toolRound("read_file", { path: "utils/date.js" }, " 12\texport function formatDate(ts) {\n 13\t return new Date(ts).toISOString().slice(0, 10);\n" + " …\n".repeat(60)),
...toolRound("read_file", { path: "tests/date.test.js" }, " 8\tassert.equal(formatDate(0), '1970-01-01');\n" + " …\n".repeat(40)),
...toolRound("edit_file", { path: "utils/date.js", old_string: "function formatDate(ts) {", new_string: "function formatDate(ts, tz = 'UTC') {" }, "已编辑 utils/date.js"),
...toolRound("run_shell", { command: "npm test" }, "FAIL tests/date.test.js\n ✕ formats with timezone (invalid tz)\n" + " at …\n".repeat(30)),
...toolRound("read_file", { path: "utils/date.js" }, " 12\texport function formatDate(ts, tz = 'UTC') {\n" + " …\n".repeat(60)),
...toolRound("edit_file", { path: "utils/date.js", old_string: "toISOString().slice(0, 10)", new_string: "new Intl.DateTimeFormat('en-CA', { timeZone: tz }).format(d)" }, "已编辑 utils/date.js"),
...toolRound("run_shell", { command: "npm test" }, "FAIL tests/date.test.js\n ✕ legacy format (expected '1970-01-01', got '1970-01-01,')\n" + " at …\n".repeat(30)),
...toolRound("edit_file", { path: "tests/date.test.js", old_string: "formatDate(0)", new_string: "formatDate(0, 'UTC')" }, "已编辑 tests/date.test.js"),
...toolRound("run_shell", { command: "npm test" }, "PASS tests/date.test.js (12 tests)\n" + " ✓ …\n".repeat(12)),
];
const LAUNCH_IDX = messages.findIndex((m) => m.content === LAUNCH);
const preview = (m) =>
m.role === "assistant" && m.tool_calls?.length
? `assistant → ${m.tool_calls[0].function.name}(${m.tool_calls[0].function.arguments.slice(0, 40)}…)`
: `${m.role.padEnd(9)} ${(m.content ?? "").replace(/\s+/g, " ").slice(0, 50)}…`;
// ─── 场景一:触发判定 ────────────────────────────────────────────────────
console.log("━━━ 场景一:触发判定(usage 对照 128k 窗口,阈值 75%) ━━━");
for (const usage of [
{ prompt_tokens: 58_000, completion_tokens: 1_200, total_tokens: 59_200 },
{ prompt_tokens: 98_400, completion_tokens: 1_800, total_tokens: 100_200 },
]) {
const d = shouldCompact({ usage, contextWindow: 128_000, triggerPercent: 75, messageCount: messages.length });
console.log(` usage.total_tokens=${usage.total_tokens} → ${d.compact ? "🗜️ 触发压缩" : "✅ 不压"}:${d.why}`);
}
// ─── 场景二:切片决策 + 假摘要 ───────────────────────────────────────────
console.log("\n━━━ 场景二:切片决策(保什么 / 压什么 / 启动消息逐字保留) ━━━");
const naive = messages.length - 8;
const keepFrom = compactSplitIndex(messages, { keepRecent: 8 });
console.log(` 共 ${messages.length} 条消息。只看"尾部保底 8 条",该从第 ${naive} 条切——`);
console.log(` 但那样启动任务的用户消息(第 ${LAUNCH_IDX} 条)就会被摘要转述掉。`);
console.log(` 分割点回拉到最后一条真实用户消息:实际 keepFrom = ${keepFrom}。逐条判决:`);
messages.forEach((m, i) => {
const mark = i < keepFrom ? "🗜️ 压缩" : i === LAUNCH_IDX ? "📌 保留 ←启动消息,逐字" : "📌 保留";
console.log(` [${String(i).padStart(2)}] ${mark} ${preview(m)}`);
});
// 摘要模型替身:真实实现是一次不带 tools 的 API 调用(见 agent.mjs)。
const fakeSummarize = async () =>
[
"1. 任务目标:用户原话——\"这个仓库的测试是怎么组织的?大概讲讲。\"(该任务已完成并已回答)",
"2. 已完成:确认测试用 node --test 跑 tests/ 目录,按模块分文件。",
"3. 未完成:无(此段落只覆盖被压缩的旧任务)。",
"4. 涉及文件与命令:package.json、tests/;ls tests。",
"5. 关键决定与坑:无。",
].join("\n");
const ok = await compactMessages(messages, { summarize: fakeSummarize, keepRecent: 8 });
console.log(`\n 压缩完成:${messages.length} 条 → ${ok.messages.length} 条(压掉 ${ok.dropped} 条,降级=${ok.degraded})`);
console.log(" 压缩后的消息形状:");
console.log(` [0] 摘要消息(role=user): ${ok.messages[0].content.replace(/\s+/g, " ").slice(0, 56)}…`);
console.log(` [1] ${preview(ok.messages[1])} ← 启动消息,一字未动`);
console.log(` [2..${ok.messages.length - 1}] 当前任务的全部工具往返,原样保留`);
console.log("\n —— 回拉不是无限的:把上限压到 1000 字符再切一次 ——");
const bounded = compactSplitIndex(messages, { keepRecent: 8, maxAnchorChars: 1000 });
console.log(` 当前任务的历史超出上限,放弃回拉,keepFrom = ${bounded}(启动消息进了压缩区)。`);
console.log(" 此时兜底的是摘要 prompt 第 1 栏:\"逐字引用用户原话,禁止转述\"。");
// ─── 场景三:摘要失败 → 降级 ────────────────────────────────────────────
console.log("\n━━━ 场景三:摘要模型挂了(超时/限流),压缩绝不能毁掉会话 ━━━");
const fallback = await compactMessages(messages, {
summarize: async () => { throw new Error("429 rate limited"); },
keepRecent: 8,
});
console.log(` 摘要调用抛出 429 → 自动降级为提取式摘要(degraded=${fallback.degraded}),会话照常继续。`);
console.log(" 降级摘要节选:");
for (const line of fallback.summary.split("\n").slice(0, 5)) console.log(` ${line}`);
console.log(` …(共 ${fallback.summary.split("\n").length} 行)`);
// ─── 场景四:回退/分支后,压缩产物是丢是留 ──────────────────────────────
//
// 聊天产品迟早要做"撤回 / 从这条消息创建分支"。此时会话有两份历史:
// · 完整文字稿 transcript —— 渲染层展示用,从未被压缩
// · 模型视图 modelView —— 场景二压缩后的 [摘要 + 尾部]
// 压缩后的新消息双写进两份(真实引擎 appendMessage 同款)。
// 回退时最顺手的实现是"从完整文字稿重建、把摘要当缓存清掉"——坑就在这。
console.log("\n━━━ 场景四:回退/分支后,压缩产物(摘要)是丢是留? ━━━");
const followUp = { role: "user", content: "顺手把 parseDate 也支持一下 tz 参数。" };
const transcript = [...messages, followUp]; // 完整文字稿(回退的裁剪对象)
const modelView = [...ok.messages, followUp]; // 压缩后的模型视图
const chars = (msgs) => msgs.reduce((n, m) => n + (m.content?.length ?? 0), 0);
// 用户在 followUp 处撤回(分支到它之前):
const naiveFork = transcript.slice(0, transcript.indexOf(followUp));
console.log(` 幼稚分支(丢弃摘要,从文字稿重建):${naiveFork.length} 条原文,约 ${chars(naiveFork)} 字符`);
console.log(" → 原文水位和压缩前一样高,下一轮触发判定立刻再压一次:白付一次摘要调用,");
console.log(" 且新摘要 ≠ 旧摘要(保留的细节会洗牌)——用户看到\"从哪回退都触发压缩\"。");
// 正确做法:切点消息在压缩后视图里找得到 ⇒ 摘要只覆盖切点之前的内容 ⇒ 随分支保留
const cut = modelView.indexOf(followUp);
const reuseFork = modelView.slice(0, cut);
console.log(` 复用分支(裁剪压缩后视图):${reuseFork.length} 条,约 ${chars(reuseFork)} 字符([0] 仍是摘要消息)`);
console.log(" → 落在\"摘要 + 尾部\"水位,零额外压缩。");
// 反例:撤回进被压缩区(比如回到最早那条 user)——切点消息在 modelView 里找不到
const earliest = messages[0];
console.log(` 反例:回退到第 0 条("${earliest.content.slice(0, 18)}…"):`);
console.log(` 它在压缩后视图里${modelView.includes(earliest) ? "找得到" : "找不到"} ⇒ 旧摘要概括了刚被撤回的"未来",`);
console.log(" 复用会把撤回的内容从摘要里泄漏回去 ⇒ 这种情况才丢弃摘要、用原文重建。");
console.log(" 判据一句话:切点消息在压缩后视图里找得到就保留摘要并裁剪视图;找不到才重建。");
|
loop-budget.mjs 与 s05 完全相同(防空转看门狗),这里不重复贴,见上方 s05 小节。
① 触发时机:用服务商报告的 usage,不自己数 token#
第一反应是自己算 token 数。但你没有服务商的分词器,本地估算(tiktoken 也一样)只是近似,中文误差可超 15%。估少了会在真实窗口边界撞出 context too long,来不及压缩。
正确做法零成本:每次响应都带 usage,是服务商报告的准确数字。total_tokens 约等于下一轮要携带的全部历史,超过窗口阈值(默认 75%)就压缩:
1
2
3
4
5
| // 流式调用需在请求里加 stream_options: {"include_usage": true},
// usage 才会出现在流的最后一片——不加则拿不到用量,压缩永远不会触发
const used = usage.total_tokens ?? (usage.prompt_tokens ?? 0) + (usage.completion_tokens ?? 0);
const threshold = Math.floor((contextWindow * triggerPercent) / 100);
if (used >= threshold) /* 触发压缩 */;
|
留 25% 余量:压缩本身还要调一次模型、摘要也占空间,得在仍有余地时动手。
② 压缩的形状:三段式,启动消息逐字保留#
压缩不是"全部换成摘要"。正确形状是三段:
1
2
3
4
| [system] ← 不动(它本来就不在 messages 里)
[中段历史] → 换成模型生成的结构化摘要
[启动本轮任务的用户消息] → 逐字保留 ★
[最近的尾部消息] → 原样保留(模型正在用的工作记忆)
|
尾部是模型的工作记忆,压掉等于打断手头操作。启动消息逐字保留是本章核心:压缩总在工具循环中途触发,“最近 N 条"全是工具结果,原始指令恰好落在被压缩区——被转述后,模型从此在转述版指令上工作(真实产品踩过同坑)。
实现是把分割点回拉到最后一条真实用户消息:
1
2
3
4
5
6
7
| let keepFrom = messages.length - keepRecent;
const lastUser = messages.findLastIndex(isRealUser);
if (lastUser >= 0 && lastUser < keepFrom) {
if (charsOf(messages.slice(lastUser)) <= maxAnchorChars) keepFrom = lastUser;
}
// 切口不能落在 assistant(tool_calls)/tool 一对中间,否则下轮请求 400
while (keepFrom > 0 && messages[keepFrom].role === "tool") keepFrom--;
|
注意 isRealUser:历史里的 user 消息不全是用户说的——s03 看门狗注入的纠偏消息、上次压缩留下的摘要也是 role:"user"。锚点停在它们身上,指令仍会丢,所以按已知前缀([上下文压缩]、自动纠偏触发:)排除合成消息。
回拉有上限:启动消息若在几百条之前,全保留就腾不出空间——超限时放弃,由下一条兜底。
③ 摘要 prompt:按栏目填写,不是笼统总结#
“总结一下上面的对话"得到的是泛泛叙述,丢的恰好是接续任务最需要的信息。让模型按栏目填写,每栏对应压缩后第一轮会用到的内容:
1
2
3
4
5
| 1. 任务目标:用户让你做什么。逐字引用用户原话,禁止转述。
2. 已完成:做了哪些事、各自的结论。
3. 未完成 / 待办:接下来该做什么,按优先级排。
4. 涉及的文件与关键命令:完整路径和完整命令,逐字保留。
5. 关键决定与踩过的坑:为什么选了这条路,哪些路已被证明走不通。
|
第 1 栏的"逐字引用"是决定②的双保险:即使启动消息因超长没能逐字保留,原话也还在摘要里。第 5 栏容易被忽略:不记录走不通的路,模型会把失败路径重走一遍。
④ 摘要失败时的降级#
摘要要调一次模型,而调用可能限流、超时、断网。此刻会话已接近窗口上限,下轮再试来不及——压缩不能因摘要失败而毁掉会话。所以要一条不会失败的降级路径:提取式摘要,纯字符串处理,截每条消息首尾拼成骨架:
1
2
3
4
5
6
| try {
summary = await summarize(toSummarySource(middle));
} catch {
degraded = true;
summary = extractiveSummary(middle); // 不智能,但零依赖、不会失败
}
|
有损的记忆也比崩溃的会话好。
⑤ 回退与分支:压缩产物随切点走,不是易失缓存#
聊天产品迟早要做"撤回 / 从这条消息创建分支”。此时会话有两份历史:完整文字稿(渲染层展示用,从未被压缩)和模型视图(压缩后的 [摘要 + 尾部],新消息双写进两份)。回退最顺手的实现,是从完整文字稿重建、把摘要当派生缓存清掉——反正超阈值还会再压。这个"反正"就是坑:会话长到压缩过,裁到切点的原文几乎必然仍超阈值,于是每次回退/分支都白付一次摘要调用,用户看到的是"从哪回退都触发压缩”。更隐蔽的是重摘要不幂等:新摘要保留的细节和旧摘要不同,回退一次,agent 的记忆就洗牌一次。
判据只有一句话:切点消息在压缩后视图里找得到 ⇒ 旧摘要只覆盖切点之前的内容 ⇒ 摘要随分支保留,把压缩后视图按切点裁剪即可;找不到(撤回进了被压缩区)⇒ 旧摘要概括了刚被撤回的"未来",复用会把撤回的内容泄漏回去 ⇒ 这种情况才丢弃摘要、用原文重建:
1
2
3
4
5
6
7
8
| const cut = modelView.findIndex((m) => m.id === cutMessageId);
if (cut >= 0) {
branch.modelView = modelView.slice(0, cut); // 摘要在 [0],天然保留
branch.summary = session.summary; // 高频路径:零额外压缩
} else {
branch.modelView = undefined; // 低频路径:原文重建,
branch.summary = undefined; // 下轮按需重新压缩
}
|
前者是高频路径——用户几乎总是撤回最近几条;后者才需要付重摘要的钱。值得一提 codex 的架构让这条判据不需要写出来:它的 fork 是对持久化事件流做前缀截断,而压缩本身就是流里的一条 Compacted 事件(带着替换历史)——切点在它之后,它自然留在前缀里;切点在它之前,它自然被截掉。快照式的 fork(复制状态对象、清空派生字段)没有这份免费午餐,两条分支都得手写,而且很容易全部写成第二条。
运行:#
免 key 演示:
1
| node .\02-上下文缓存与记忆\s06_compaction\demo.mjs
|
接上真实模型(想看压缩,把 AGENT_COMPACT_PERCENT 调到 5,让它连续读几个大文件):
1
2
| $env:AGENT_API_KEY = "sk-xxx"
node .\02-上下文缓存与记忆\s06_compaction\agent.mjs
|
输出节选(真实运行):
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
| ━━━ 场景二:切片决策(保什么 / 压什么 / 启动消息逐字保留) ━━━
共 27 条消息。只看"尾部保底 8 条",该从第 19 条切——
但那样启动任务的用户消息(第 6 条)就会被摘要转述掉。
分割点回拉到最后一条真实用户消息:实际 keepFrom = 6。逐条判决:
[ 0] 🗜️ 压缩 user 这个仓库的测试是怎么组织的?大概讲讲。…
...
[ 6] 📌 保留 ←启动消息,逐字 user 帮我把 utils/date.js 里的 formatDate 改成支持时区参数 tz,默认 UTC…
[ 7] 📌 保留 assistant → run_shell({"command":"rg -n formatDate src utils"}…)
...
压缩完成:27 条 → 22 条(压掉 6 条,降级=false)
━━━ 场景三:摘要模型挂了(超时/限流),压缩绝不能毁掉会话 ━━━
摘要调用抛出 429 → 自动降级为提取式摘要(degraded=true),会话照常继续。
|
本章每次压缩都从头生成摘要。改成滚动摘要:把上一次的摘要作为输入传给摘要模型,并在 prompt 里加一条"上一份摘要中仍然相关的部分逐字复制,不要改写"。想想为什么"逐字复制"比"合并改写"更重要(提示:和启动消息逐字保留是同一个道理——转述会累积走样)。
思考题:压缩后的摘要消息每轮都会重发一遍。它的内容是稳定的吗?如果你在摘要里加上"压缩于 {当前时间}",会发生什么?(这与成本有关,下一章展开。)
练习 1 的答案:滚动摘要#
思路(三步)#
- 在
compactMessages 里先找中段里有没有上一份摘要——它是以 [上下文压缩] 开头的 user 消息,一定排在被压中段的最前面; - 把上一份摘要的内容剥壳后,和本轮新增对话一起拼成摘要模型的输入;
- 在 SUMMARY_PROMPT 里加一条"逐字复制"的指令。
改动一:SUMMARY_PROMPT 加一句#
1
2
| 如果提供了上一份摘要:其中仍然相关的部分必须逐字复制进新摘要,一字不改;
只针对新增内容做新的概括。合并/改写旧的摘要会累积走样。
|
改动二:compactMessages 传滚动输入#
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
| // 上一份摘要在中段里,以 [上下文压缩] 开头
function extractSummaryBody(content) {
// 剥掉"更早的 N 条对话已被压缩…"那层说明壳,只留摘要本体
return String(content ?? "").replace(/^\[上下文压缩\]/, "").trim();
}
// compactMessages 内部:
const prev = middle.find((m) => String(m.content ?? "").startsWith("[上下文压缩]"));
const source = toSummarySource(middle);
const rollingInput = prev
? `上一份摘要(其中仍然相关的部分必须逐字复制,不要改写):\n\n${extractSummaryBody(prev.content)}\n\n---\n\n以下是本轮新增的对话(从旧到新):\n\n${source}`
: source; // 第一次压缩没有旧摘要,退化为原来的全量输入
summary = (await summarize(rollingInput))?.trim();
|
为什么"逐字复制"比"合并改写"更重要#
合并改写 = 让模型把"旧摘要 + 新对话"重新提炼成一份新摘要。但旧摘要本身就是上一次压缩的转述产物——再转述一次,走样叠加:
1
2
3
4
5
6
| 原始指令:把 utils/date.js 的 formatDate 改成支持时区 tz,默认 UTC;改完跑 npm test
压缩① → 摘要A:用户要求让 formatDate 支持时区参数 tz
压缩②(合并改写)→ 重新转述 → 摘要B:用户想改日期函数的时区(tz 丢了)
压缩③ → 摘要C:用户在优化日期相关代码
……几次压缩后,agent 只剩"用户要优化代码"
|
这正是 s06 开头那个症状,只不过这次发生在摘要层:转述 → 转述 → 转述,信息每层丢一点,最后任务指令面目全非。
逐字复制 = 给旧摘要一个"比特级保真"承诺:一旦某个事实进了摘要,后续所有压缩里它都原样存活(除非被新内容取代)。于是走样只发生一次(第一次写摘要时),不随压缩次数累积。
和启动消息逐字保留是同一个道理——都是对抗"转述走样累积",只是防护手段不同:
| 防护对象 | 手段 | 防的是什么 |
|---|
| 启动消息 | 切片:把它留在压缩区外 | 别被转述 |
| 旧摘要 | 逐字复制:让它原样携带过压缩 | 进了也别被改写 |
一个防"别进压缩区",一个防"进了也别被改写"——两条防线合起来,任务指令才活得过长任务。
练习 2 的答案:摘要里加时间戳#
摘要内容稳定吗?#
稳定。摘要消息在压缩那一刻构造一次,之后每一轮都原样重发,字节不变。这个"稳定"不是巧合,而是后面 prompt 缓存(s07)能生效的前提:服务商按请求前缀做缓存,前缀字节不变 → 每轮只有新增的尾巴需要重新计算 → 省钱省时。
加"压缩于 {当前时间}“会怎样?#
分两种情况:
| 时间戳怎么算 | 内容稳定? | 后果 |
|---|
| 压缩那一刻固定(构造一次) | ✅ 仍稳定 | 缓存不坏,但加它毫无意义——纯废话 |
| 每轮重算(发送时的新鲜时间) | ❌ 每轮都变 | 前缀缓存键每轮都换 → 缓存全 miss → 每轮把整个上下文(几万 token 历史)重新算一遍 → 成本、延迟成倍上升 |
真正的坑是第二种:写代码时图省事用了 new Date() 且每次构建消息都重算——你亲手把字节稳定变成了字节不稳定,缓存机制瞬间失效。
设计铁律#
进入"每轮重发前缀"的内容必须确定性:不能有每轮变化的当前时间、随机 id、易变状态。判断方法很简单——这条消息下一次发送时,字节会不会变?会变就不该放进去。这条原则到 s07(prompt 缓存)会正式展开。
与真实产品对照(延伸阅读)#
本章是 Reina(本系列对照的生产级 agent)packages/core/src/compaction.ts 的最小化移植。先补正文各决定在生产版里的出处:
- 决定①:Reina 的
sessionContextTokens 同样以 provider 报告的总量为准,本地 o200k 估算只在拿不到 provider 数字时兜底(会话第一轮、或服务商不报 total)——源码注释原话:估算比真值 “typically ~15-20% low”。窗口大小同样是配置出来的(models.json);个别服务商的模型列表接口会给 context_length,但不可依赖。 - 决定②:正是 Reina 修复过的问题(commit
ce4724f “keep the launching user message verbatim through compaction”);上游 agent 框架 hermes 也遇到过同一问题(issue #10896)。 - 决定④:Reina 的
buildCompactSummary 是同样的结构:模型摘要用 try/catch 包住,任何异常落到 extractiveSummary,源码注释原话——“so compaction never blocks the main turn”。
生产版多出的部分同样值得了解:
- 触发阈值不是固定的 75%:有效窗口 = 窗口 − 20k(给输出留的),默认再留 13k 安全垫(400k+ 窗口留 30k、800k+ 留 50k);用户可用
REINA_COMPACTION_TRIGGER_PERCENT 换成百分比语义。另有净收益门槛:可压前缀不足 2000 token 就拒绝压——否则 /compact 每次剥一条小消息、再注入一条差不多大的摘要,永远压不完。 - 回拉上限是有效窗口的 25%(
COMPACT_TAIL_USER_ANCHOR_WINDOW_FRACTION),超限时靠摘要里的逐字引用段兜底——和本章 maxAnchorChars 同构。 - 摘要 prompt 是 9 个栏目(Primary Request and Intent / Errors and Fixes / All user messages / Current Work / Next Step…),要求先写
<analysis> 草稿再输出 <summary>,且用 prompt 前后双重围栏禁止工具调用——因为部分 OpenAI 兼容端点会无视 tools: [] 照样发起工具调用。 - 被压掉的历史没有消失:全文落盘到
.reina/conversation_history/<sessionId>.md,摘要消息里附路径指针,模型需要旧细节时可以自己去读——这是 s04"无损溢出"思想在压缩上的复用。 - 决定⑤是 Reina 真实修过的坑(2026-07):
forkToMessage(创建分支)和 truncateFromMessageIndex(撤回/删除消息)最初都无条件丢弃 modelMessages/summary/compactBoundaries,表现正是"从哪回退都再压一次”;修复后用同一句判据(切点消息是否还在压缩后视图里)决定复用还是重建。codex 侧的对应物:Compacted 检查点是 rollout 流的一等公民,重建从最新存活检查点的 replacement_history 起步(rollout_reconstruction.rs),且有集成测试逐字断言 fork 后的请求仍含压缩摘要(compact_resume_fork.rs —— “after-fork user texts should preserve compacted user history prefix”)。
Claude Code 的行为也可以观察到:上下文快满时状态栏出现 “Context left until auto-compact: 8%",压缩后它对之前任务的记忆变成摘要形式——但最初的任务指令还在,是同一套机制。
Prompt 缓存#
跑一个 30 轮的任务,账单会吓你一跳:agent 每轮都把越来越长的对话历史全量重发,第 1 轮发 2k token,第 30 轮就是 100k,累计发送的输入是历史长度的几十倍——花钱大头全在输入侧。
功能相同的两个实现,账单可以差出近 7 倍——不命中缓存的原因往往只是 system prompt 里的一行 当前时间:...。
解决方案#
服务商为此提供了前缀缓存:这次请求的开头和上次逐字节相同的部分,单价降到约十分之一。原理:模型收到请求后要把整个 prompt 从头算一遍(prefill,占输入侧几乎全部算力);开头和上次相同时,中间结果(KV cache)可直接复用,几乎不花算力。第 30 轮请求里前 99% 与上一轮相同——命中打一折,不命中全价。以 30 轮、每轮 60k、累计输入 1.8M token 为例:
- 全部未命中:1.8M × 全价
- 稳定 95% 命中:1.8M × (5% × 全价 + 95% × 一折) ≈ 0.145 × 全价,省 85%
(DeepSeek / OpenAI 的缓存自动生效;Anthropic 要显式打 cache_control 断点,否则命中率恒为 0。)做法是三条纪律保持前缀逐字节稳定,加一套仪表测量命中率。
实现:#
agent.mjs#
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
218
219
220
221
222
223
224
225
226
227
228
229
230
231
232
233
234
235
236
237
238
239
240
241
242
243
244
245
246
247
248
249
250
251
252
253
254
255
256
257
258
259
260
261
262
263
264
265
266
267
268
269
270
271
272
| #!/usr/bin/env node
// s07 —— 缓存命中工程:s03 的 agent(工具注册表 + 看门狗)+ 缓存命中率仪表盘。
//
// 新增的全部内容:
// · chat() 读回 usage,兼容两种缓存字段(DeepSeek / OpenAI)
// · 每轮打印 prompt tokens、缓存命中/未命中、按"命中≈1折"估算省了多少钱
// · 三条纪律落在代码里:system 字节稳定、tools 顺序稳定、messages 只追加
//
// 运行方式与 s03 相同:AGENT_API_KEY=sk-xxx node agent.mjs
import readline from "node:readline/promises";
import { execSync } from "node:child_process";
import { readFileSync, writeFileSync, mkdirSync } from "node:fs";
import path from "node:path";
import { LoopBudget, isRecoverable, repairPrompt } from "./loop-budget.mjs";
const BASE_URL = process.env.AGENT_BASE_URL ?? "https://api.deepseek.com/v1";
const API_KEY = process.env.AGENT_API_KEY;
const MODEL = process.env.AGENT_MODEL ?? "deepseek-chat";
if (!API_KEY) {
console.error("缺少 AGENT_API_KEY。任何 OpenAI 兼容的 key 都行(DeepSeek / Kimi / GLM / OpenRouter / 本地 Ollama)。");
process.exit(1);
}
// 纪律①:system prompt 必须逐轮字节稳定。cwd 和 platform 在进程生命周期内
// 不变,可以进来;时间戳、随机数、"今天是几号"是缓存杀手——
//
// ❌ const SYSTEM = `当前时间:${new Date().toISOString()}\n你是…`;
//
// 这样写,每轮请求的第 6 个字符就开始不同,前缀缓存从那里断掉,
// 后面的一切(tools、全部历史)永远按全价计费。每轮会变的信息
// 放进"最后一条用户消息"随尾部走(见 demo.mjs 的对照实验)。
const SYSTEM = `你是一个运行在用户终端里的编程助手。
优先用专用工具(read_file / write_file / edit_file)操作文件;run_shell 用于其余一切。
先观察真实世界再行动,不要凭空猜测文件内容。
当前目录:${process.cwd()}
操作系统:${process.platform}`;
// ─── 工具注册表(与 s03 相同)─────────────────────────────────────────────
const REGISTRY = {
run_shell: {
description: "在用户的终端里执行一条 shell 命令,返回 stdout 和 stderr。",
parameters: {
type: "object",
properties: { command: { type: "string", description: "要执行的命令" } },
required: ["command"],
},
handler: ({ command }) => {
console.log(`\x1b[33m $ ${command}\x1b[0m`);
try {
const out = execSync(command, {
encoding: "utf8",
timeout: 30_000,
maxBuffer: 1024 * 1024,
stdio: ["ignore", "pipe", "pipe"],
});
return out.trim() || "(命令执行成功,无输出)";
} catch (err) {
return `命令失败(exit ${err.status ?? "?"}):\n${err.stdout ?? ""}${err.stderr ?? err.message}`;
}
},
},
read_file: {
description: "读取一个文本文件,返回带行号的内容。",
parameters: {
type: "object",
properties: { path: { type: "string", description: "文件路径(相对或绝对)" } },
required: ["path"],
},
handler: ({ path: p }) => {
console.log(`\x1b[33m read ${p}\x1b[0m`);
const text = readFileSync(p, "utf8");
const CAP = 50_000;
const body = text.length > CAP ? text.slice(0, CAP) + `\n…(截断,共 ${text.length} 字符)` : text;
return body
.split("\n")
.map((line, i) => `${String(i + 1).padStart(4)}\t${line}`)
.join("\n");
},
},
write_file: {
description: "写入一个文件(整体覆盖)。父目录不存在时自动创建。",
parameters: {
type: "object",
properties: {
path: { type: "string", description: "文件路径" },
content: { type: "string", description: "完整的文件内容" },
},
required: ["path", "content"],
},
handler: ({ path: p, content }) => {
console.log(`\x1b[33m write ${p} (${content.length} 字符)\x1b[0m`);
mkdirSync(path.dirname(path.resolve(p)), { recursive: true });
writeFileSync(p, content);
return `已写入 ${p}`;
},
},
edit_file: {
description:
"对文件做一次精确替换。old_string 必须在文件中出现且仅出现一次(带上足够的上下文来保证唯一),否则会失败。",
parameters: {
type: "object",
properties: {
path: { type: "string", description: "文件路径" },
old_string: { type: "string", description: "要被替换的原文(必须唯一匹配)" },
new_string: { type: "string", description: "替换成的新文本" },
},
required: ["path", "old_string", "new_string"],
},
handler: ({ path: p, old_string, new_string }) => {
console.log(`\x1b[33m edit ${p}\x1b[0m`);
const text = readFileSync(p, "utf8");
const first = text.indexOf(old_string);
if (first === -1) return `编辑失败:old_string 在 ${p} 中找不到。请先 read_file 确认原文。`;
if (text.indexOf(old_string, first + 1) !== -1)
return `编辑失败:old_string 在 ${p} 中出现多次。请带上更多上下文让它唯一。`;
// 不能用 text.replace(old, new):new_string 里的 $$ / $& 会被 JS 当替换模式展开,静默写坏文件。
writeFileSync(p, text.slice(0, first) + new_string + text.slice(first + old_string.length));
return `已编辑 ${p}`;
},
},
};
// 纪律②:tools 数组也在前缀里。Object.entries 的顺序 = 注册表的书写顺序,
// 进程内每轮相同——别在运行时对它排序、增删或拼接动态描述。
const TOOLS = Object.entries(REGISTRY).map(([name, t]) => ({
type: "function",
function: { name, description: t.description, parameters: t.parameters },
}));
const FAILURE_RE = /^(命令失败|编辑失败|工具执行出错|未知工具|工具参数)/;
function dispatch(call) {
const tool = REGISTRY[call.function.name];
if (!tool) return `未知工具:${call.function.name}`;
let args;
try {
args = JSON.parse(call.function.arguments || "{}");
} catch (err) {
return `工具参数不是合法 JSON:${err.message}`;
}
try {
return tool.handler(args);
} catch (err) {
return `工具执行出错:${err.message}`;
}
}
// ─── 缓存仪表盘:让省钱可见 ──────────────────────────────────────────────
// 兼容读两种 usage 字段:
// DeepSeek:usage.prompt_cache_hit_tokens / usage.prompt_cache_miss_tokens
// OpenAI: usage.prompt_tokens_details.cached_tokens(未命中 = prompt - cached)
// 都没有就返回 undefined——有的服务商/本地模型根本不报缓存。
function readCacheUsage(usage = {}) {
const prompt = usage.prompt_tokens ?? 0;
let hit;
if (typeof usage.prompt_cache_hit_tokens === "number") hit = usage.prompt_cache_hit_tokens;
else if (typeof usage.prompt_tokens_details?.cached_tokens === "number") hit = usage.prompt_tokens_details.cached_tokens;
if (hit === undefined) return { prompt };
const miss = typeof usage.prompt_cache_miss_tokens === "number" ? usage.prompt_cache_miss_tokens : prompt - hit;
return { prompt, hit, miss };
}
const sessionTotals = { prompt: 0, hit: 0 };
function printUsage(usage) {
const u = readCacheUsage(usage);
if (u.hit === undefined) {
console.log(`\x1b[36m📊 prompt ${u.prompt} tokens(该服务商未返回缓存字段)\x1b[0m`);
return;
}
sessionTotals.prompt += u.prompt;
sessionTotals.hit += u.hit;
const rate = u.prompt > 0 ? ((u.hit / u.prompt) * 100).toFixed(1) : "0.0";
// 命中部分按约 1 折计费 → 每命中 1 token 省 0.9 个全价 token。
const saved = u.prompt > 0 ? ((u.hit * 0.9) / u.prompt) * 100 : 0;
const total = sessionTotals.prompt > 0 ? ((sessionTotals.hit / sessionTotals.prompt) * 100).toFixed(1) : "0.0";
console.log(
`\x1b[36m📊 prompt ${u.prompt} | 命中 ${u.hit}(${rate}%)| 未命中 ${u.miss} | 本轮输入费≈省 ${saved.toFixed(0)}% | 会话累计命中 ${total}%\x1b[0m`,
);
}
// ─── 模型调用(与 s03 唯一的区别:读回 usage)────────────────────────────
async function chat(messages) {
const res = await fetch(`${BASE_URL}/chat/completions`, {
method: "POST",
headers: {
"content-type": "application/json",
authorization: `Bearer ${API_KEY}`,
},
body: JSON.stringify({
model: MODEL,
messages: [{ role: "system", content: SYSTEM }, ...messages],
tools: TOOLS,
}),
});
if (!res.ok) throw new Error(`API ${res.status}:${await res.text()}`);
const data = await res.json();
return { message: data.choices[0].message, usage: data.usage };
}
// ─── 主循环:s03 原样 + 每轮打印命中率 ───────────────────────────────────
// 纪律③就藏在这里:messages 只 push、从不改写。s03 的循环天生 append-only,
// 本章一行都不用改——难的不是做到,是别在后续迭代里破坏它
// (比如"帮模型省上下文"回头去截短旧的工具输出:省了 token,赔了缓存)。
async function runTurn(messages) {
const budget = new LoopBudget({ baseSteps: 12 });
let repaired = false;
while (true) {
if (!budget.canContinue()) {
const stop = budget.exhaustedStop();
console.log(`\n\x1b[31m⛔ ${stop.message}(第 ${stop.turnCount} 轮)\x1b[0m`);
return;
}
const { message: msg, usage } = await chat(messages);
printUsage(usage);
messages.push(msg);
if (msg.content) console.log(`\n${msg.content}`);
if (!msg.tool_calls?.length) return;
const records = [];
for (const call of msg.tool_calls) {
const output = dispatch(call);
messages.push({ role: "tool", tool_call_id: call.id, content: output });
let input = {};
try {
input = JSON.parse(call.function.arguments || "{}");
} catch { /* 坏参数已作为失败回填 */ }
records.push({
name: call.function.name,
input,
status: FAILURE_RE.test(output) ? "failed" : "completed",
output,
});
}
const stop = budget.recordTurn(records);
if (!stop) continue;
if (isRecoverable(stop) && !repaired) {
repaired = true;
console.log(`\n\x1b[35m🟡 看门狗触发(${stop.reason}),注入纠偏 prompt…\x1b[0m`);
messages.push({ role: "user", content: repairPrompt(stop) });
continue;
}
console.log(`\n\x1b[31m⛔ ${stop.message}(reason=${stop.reason},第 ${stop.turnCount} 轮)\x1b[0m`);
return;
}
}
const rl = readline.createInterface({ input: process.stdin, output: process.stdout });
const messages = [];
console.log(`s07 agent 已上线(${MODEL})。每轮打印缓存命中率——盯着第二轮开始的 📊 行看。Ctrl+C 退出。`);
while (true) {
const line = (await rl.question("\n你> ")).trim();
if (!line) continue;
messages.push({ role: "user", content: line });
await runTurn(messages);
}
|
demo.mjs#
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
| #!/usr/bin/env node
// s07 免 key 演示 —— 前缀缓存从哪里断,纯字符串就能算出来:
// 实验 A:时间戳写进 system → 缓存在第一行就断
// 实验 B:system 稳定,时间戳放最后一条用户消息 → 上一轮请求 100% 复用
// 实验 C:违反 append-only("好心"截短旧工具输出)→ 断点跳回历史中间
// 实验 D:浪费计数器 → 只用 provider 的 usage 数字,把每次击穿折成 token 并归因
//
// 服务商按"与上次请求逐字节相同的前缀"给缓存价(实际按 token/块粒度对齐,
// DeepSeek 是 64 token 一块;这里用字符近似,原理相同)。
//
// 运行:node s07_prompt_cache/demo.mjs
// ─── 把请求"线性化":服务商看到的就是这样一条字节流 ─────────────────────
// system、tools、每条消息依次拼接。缓存能复用的 = 和上一条字节流相同的开头。
const TOOLS = JSON.stringify([
{ name: "run_shell", description: "执行一条 shell 命令" },
{ name: "read_file", description: "读取一个文本文件" },
]);
function serializeRequest(system, messages) {
const parts = [`[system]\n${system}`, `[tools]\n${TOOLS}`];
for (const m of messages) parts.push(`[${m.role}]\n${m.content}`);
return parts.join("\n\n");
}
function commonPrefixLength(a, b) {
let i = 0;
while (i < a.length && i < b.length && a[i] === b[i]) i++;
return i;
}
function report(label, prev, cur) {
const n = commonPrefixLength(prev, cur);
const reused = ((n / prev.length) * 100).toFixed(1);
console.log(` ${label}:公共前缀 ${n} 字符(上一轮请求共 ${prev.length} 字符 → 可复用 ${reused}%)`);
if (n < prev.length) {
const from = Math.max(0, n - 16);
console.log(` 断点上下文: …${JSON.stringify(prev.slice(from, n + 12))} vs …${JSON.stringify(cur.slice(from, n + 12))}`);
} else {
console.log(" 断点在上一轮请求的末尾之后——新增的只有追加的消息,这就是理想形状。");
}
return n;
}
// ─── 伪造一段工具循环:1 条用户消息 + 两轮工具往返 ───────────────────────
const TOOL_OUTPUT_1 = ' 1\t{\n 2\t "scripts": {\n 3\t "test": "vitest run",\n 4\t "build": "tsc -p ."\n 5\t }\n' + ' …\t(省略 60 行依赖列表)\n'.repeat(12);
const round1 = [
{ role: "assistant", content: '(调用 read_file {"path":"package.json"})' },
{ role: "tool", content: TOOL_OUTPUT_1 },
];
const round2 = [
{ role: "assistant", content: '(调用 run_shell {"command":"npx vitest list"})' },
{ role: "tool", content: "test/date.test.ts\ntest/http.test.ts\ntest/utils.test.ts" },
];
// 演示用假时钟:每次调用走一秒,模拟"每轮请求时间都不同"。
let tick = 0;
const clock = () => `10:23:0${++tick}`;
// ─── 实验 A:时间戳写进 system(缓存杀手)────────────────────────────────
console.log("━━━ 实验 A:时间戳写进 system ━━━");
const badSystem = () => `当前时间:${clock()}。你是一个运行在用户终端里的编程助手。先观察真实世界再行动。`;
const userA = { role: "user", content: "看看 package.json 里有哪些 scripts,然后告诉我怎么跑测试。" };
const a1 = serializeRequest(badSystem(), [userA]);
const a2 = serializeRequest(badSystem(), [userA, ...round1]);
const a3 = serializeRequest(badSystem(), [userA, ...round1, ...round2]);
report("第 1↔2 轮", a1, a2);
report("第 2↔3 轮", a2, a3);
console.log(" 断点永远卡在时间戳的秒位上 → 后面的 tools、全部历史,每一轮都按全价重算。");
// ─── 实验 B:system 稳定,时间戳放最后一条用户消息 ───────────────────────
console.log("\n━━━ 实验 B:system 稳定,时间戳放进用户消息尾部 ━━━");
const goodSystem = "你是一个运行在用户终端里的编程助手。先观察真实世界再行动。";
const userB = { role: "user", content: `看看 package.json 里有哪些 scripts,然后告诉我怎么跑测试。\n\n[本地时间:${clock()}]` };
const b1 = serializeRequest(goodSystem, [userB]);
const b2 = serializeRequest(goodSystem, [userB, ...round1]);
const b3 = serializeRequest(goodSystem, [userB, ...round1, ...round2]);
report("第 1↔2 轮", b1, b2);
report("第 2↔3 轮", b2, b3);
console.log(" 时间没有消失——它随那条用户消息进了历史,但从此一个字节都不再变。");
// ─── 实验 C:违反 append-only(改写历史)────────────────────────────────
console.log("\n━━━ 实验 C:第 3 轮\"好心\"截短旧的工具输出 ━━━");
const trimmedRound1 = [
round1[0],
{ role: "tool", content: TOOL_OUTPUT_1.slice(0, 80) + "…(为省上下文截短)" },
];
const c3 = serializeRequest(goodSystem, [userB, ...trimmedRound1, ...round2]);
const brk = report("第 2↔3 轮", b2, c3);
console.log(` 断点从请求末尾跳回第 ${brk} 字符(那条工具输出的中间)——`);
console.log(` 之后的 ${c3.length - brk} 字符全部退回全价。省了几十个字符的上下文,赔掉的是整段后续历史的缓存。`);
console.log(" 真想省:要么当初就别让大输出进历史(s04 输出预算),要么整段压缩换摘要(s06)。");
// ─── 实验 D:浪费计数器——上一轮的 prompt,这一轮本该全是缓存读 ────────────
// A/B/C 拿着两轮请求的原文对比,能精确指出断点在哪个字节——但那是实验室条件:
// 生产里你不会留着每轮几十万字符的请求原文。生产里手上只有 provider 每轮
// 报回的三个数:prompt 总量、缓存读了多少、缓存写了多少。
// 好在"该命中多少"是可以推的:上一轮整个 prompt 刚被算过一遍,这一轮它的
// 每个 token 都该是缓存读。差出来的部分就是被重计费的浪费:
// miss = min(上一轮 prompt, 这一轮 prompt) - 这一轮缓存读
// 再看闲置了多久:超过 TTL(Anthropic 默认 5 分钟)是缓存被淘汰(正常损耗);
// 没超 TTL 就是前缀被改写了(实验 C 的病,去查 append-only)。
console.log("\n━━━ 实验 D:浪费计数器——只靠 usage 数字,量化每次击穿并归因 ━━━");
const TTL_MS = 5 * 60 * 1000; // 缓存保留时间
const NOISE = 1024; // 断点/块粒度造成的小额差异,不算浪费
function trackCacheUsage(prev, usage, now) {
const reported = usage.cacheRead + usage.cacheWrite > 0;
const next = { promptTokens: usage.prompt, at: now, reportedCache: (prev?.reportedCache ?? false) || reported };
// 第一轮没有参照;从不报缓存字段的服务商,0 也说明不了什么
if (!prev || (!reported && !prev.reportedCache)) return { next };
const missed = Math.min(prev.promptTokens, usage.prompt) - usage.cacheRead;
if (missed <= NOISE) return { next };
const idleMs = now - prev.at;
return { next, miss: { missed, idleMs, ttlExpired: idleMs > TTL_MS } };
}
// 一段会话的 usage 流水(provider 每轮报回的原始数字):
const rounds = [
{ label: "第 1 轮(会话开始) ", gap: 0, prompt: 8200, cacheRead: 0, cacheWrite: 8200 },
{ label: "第 2 轮(15 秒后) ", gap: 15e3, prompt: 11400, cacheRead: 8200, cacheWrite: 3200 },
{ label: "第 3 轮(20 秒后) ", gap: 20e3, prompt: 14100, cacheRead: 11400, cacheWrite: 2700 },
{ label: "第 4 轮(用户开会,38 分钟后)", gap: 38 * 60e3, prompt: 16300, cacheRead: 0, cacheWrite: 16300 },
{ label: "第 5 轮(10 秒后) ", gap: 10e3, prompt: 18000, cacheRead: 16300, cacheWrite: 1700 },
{ label: "第 6 轮(12 秒后,有人截短了老工具输出)", gap: 12e3, prompt: 17600, cacheRead: 5100, cacheWrite: 12500 },
];
let state, now = 0, waste = 0, misses = 0;
for (const r of rounds) {
now += r.gap;
const { next, miss } = trackCacheUsage(state, r, now);
state = next;
if (!miss) { console.log(` ${r.label}:✓ 正常`); continue; }
waste += miss.missed; misses++;
const idle = miss.idleMs >= 60e3 ? `${Math.round(miss.idleMs / 60e3)} 分钟` : `${Math.round(miss.idleMs / 1e3)} 秒`;
const verdict = miss.ttlExpired
? "闲置超过 TTL → 缓存被服务商淘汰(正常损耗,人回来了它就回来)"
: "TTL 没过 → 前缀被改写了!去查 append-only(实验 C 的病)";
console.log(` ${r.label}:✗ 浪费 ${miss.missed} tok · 闲置 ${idle} · ${verdict}`);
}
console.log(` 会话累计:浪费 ${waste} tok / ${misses} 次 —— 放到 UI 上就是一行 "Cache waste"。`);
console.log(" 注意第 4 轮和第 6 轮的数字长得几乎一样(cacheRead 掉下去了),");
console.log(" 没有 idle 归因就分不清'正常损耗'和'代码有病'——量化的意义就在这一步。");
|
① 三条纪律:保持前缀逐字节稳定#
请求的开头依次是 system prompt、tools(工具定义)、历史消息,三条纪律分别对应:
- system prompt 逐轮字节稳定。时间戳、随机数、“剩余预算 7 轮"这类每轮会变的内容会破坏缓存——变化在最开头,之后的 tools + 全部历史都按全价重算。会变的信息挪到最后一条用户消息:尾部本来就是新字节。
- tools 数组顺序稳定。工具定义和 system 一起序列化在请求最前部。不要运行时排序、按条件增删、往 description 里拼动态内容。
- messages 只追加,不改写(append-only)。任何一个字节被改动,缓存就断在那里,之后全部退回全价。常见错误是好心截短旧的工具输出——省几十 token,赔掉整段后续缓存(demo 实验 C)。
这三条纪律难的不是做到,而是在后续迭代中不被悄悄破坏——缓存击穿是静默的,没有报错,只体现在账单上。
② 测量:读取 usage 里的命中数据#
不打印命中率,就无法验证纪律是否生效。服务商在 usage(响应附带的用量字段)里报了账,但字段名不统一:
1
2
3
4
5
| // DeepSeek:usage.prompt_cache_hit_tokens / usage.prompt_cache_miss_tokens
// OpenAI: usage.prompt_tokens_details.cached_tokens(未命中 = prompt - cached)
let hit;
if (typeof usage.prompt_cache_hit_tokens === "number") hit = usage.prompt_cache_hit_tokens;
else if (typeof usage.prompt_tokens_details?.cached_tokens === "number") hit = usage.prompt_tokens_details.cached_tokens;
|
每轮打印一行统计(第一轮命中 0% 正常——要有上一次请求才有可复用前缀):
1
| 📊 prompt 48213 | 命中 47616(98.8%)| 未命中 597 | 本轮输入费≈省 89% | 会话累计命中 91.2%
|
健康的 agent 从第二轮起命中率应在 90% 以上,且随任务变长越来越高。异常时对照下表排查:
| 现场 | 诊断 |
|---|
| 每一轮都是 0% | 前缀在最开头就断了——system 或 tools 里混进了每轮变化的字节(时间戳最常见) |
| 一直 95%+,某轮突然跌到 50% | 历史中段被改写了——检查是否有代码在回头修剪旧消息(违反 append-only) |
| 压缩后的第一轮跌到接近 0% | 预期行为:s06 把历史整段重写,缓存必然失效一次(system + tools 那一小段还能命中),用一次全价换之后每轮更短的前缀 |
| 命中率正常但账单没降 | 确认服务商确实支持前缀缓存并读对了字段——读不到字段时本章 agent 会明确提示,而不是打印一个假的 0 |
往尾部追加的机制天然无害(如 s03 看门狗的纠偏消息),危险的只有回头改写。
③ 记账:把每次击穿折成 token 数,并归因#
②的统计行和排查表有一个前提:有人在看。但缓存击穿是静默、偶发的——TTL 过期只在用户走开又回来的那一轮出现,一个改写历史的 bug 可能只在特定分支触发。没人会每轮盯着命中率,等发现时只剩一张说不清原因的账单。
所以在每轮统计之上再加一层会话级记账。它不需要请求原文(字节对比是实验室条件,生产里没人保留每轮几十万字符的 payload),只吃 provider 每轮报回的 usage 数字,靠一个推断补出"应然”:上一轮的整个 prompt 刚被算过一遍,这一轮它的每个 token 都应该是缓存读。差值就是被重计费的浪费:
1
| miss = min(上一轮 promptTokens, 这一轮 promptTokens) - 这一轮 cacheRead
|
配三条防误报纪律,缺一个数字就不可信:
- 噪声地板:断点/块粒度天然造成小额差异(DeepSeek 64 token 一块),1k token 以下不计;
- 首轮与不报账的服务商不计:第一轮没有参照;从不报缓存字段的服务商,
cacheRead=0 说明不了任何事——但只要它报过一次,之后的 0 就是真未命中(用一个"报过账"的粘性标记区分两者); - 压缩边界重置:s06 把历史整段重写,那次击穿是买来的(用一次全价换之后更短的前缀),记进浪费会把预期成本和意外事故混在一起——压缩时把追踪器清零。
最后一步是归因。浪费数字本身分不清"正常损耗"还是"代码有病”,能分清的是闲置时长:距上一轮超过 TTL(Anthropic 默认 5 分钟),是缓存被服务商淘汰,人回来了它自然回来;没超 TTL 就是前缀被改写了,直接去查 append-only(②表格第二行的现场,现在有了数字和时间戳)。demo 实验 D 里第 4 轮和第 6 轮的 usage 数字长得几乎一样,判词完全相反——归因就差在 idleMs 这一个维度上。
累计值(总浪费 token 数 + 击穿次数)放进会话状态持久化,在 UI 上常驻一行。它和②的关系是仪表盘和示波器的关系:②告诉你为什么断(对着排查表看现场),③告诉你断了多少钱(不看的时候也在记)。
运行:#
免 key 演示:
1
| node .\02-上下文缓存与记忆\s07_prompt_cache\demo.mjs
|
输出节选(直接算出缓存断点位置):
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
| ━━━ 实验 A:时间戳写进 system ━━━
第 2↔3 轮:公共前缀 21 字符(上一轮请求共 594 字符 → 可复用 3.5%)
断点上下文: …"em]\n当前时间:10:23:02。你是一个运行在用户终" vs …"em]\n当前时间:10:23:03。你是一个运行在用户终"
━━━ 实验 B:system 稳定,时间戳放进用户消息尾部 ━━━
第 2↔3 轮:公共前缀 597 字符(上一轮请求共 597 字符 → 可复用 100.0%)
断点在上一轮请求的末尾之后——新增的只有追加的消息,这就是理想形状。
━━━ 实验 C:第 3 轮"好心"截短旧的工具输出 ━━━
第 2↔3 轮:公共前缀 353 字符(上一轮请求共 597 字符 → 可复用 59.1%)
━━━ 实验 D:浪费计数器——只靠 usage 数字,量化每次击穿并归因 ━━━
第 3 轮(20 秒后) :✓ 正常
第 4 轮(用户开会,38 分钟后):✗ 浪费 14100 tok · 闲置 38 分钟 · 闲置超过 TTL → 缓存被服务商淘汰(正常损耗)
第 5 轮(10 秒后) :✓ 正常
第 6 轮(12 秒后,有人截短了老工具输出):✗ 浪费 12500 tok · 闲置 12 秒 · TTL 没过 → 前缀被改写了!去查 append-only
会话累计:浪费 26600 tok / 2 次 —— 放到 UI 上就是一行 "Cache waste"。
|
接上真实模型:
1
2
| $env:AGENT_API_KEY = "sk-xxx"
node .\02-上下文缓存与记忆\s07_prompt_cache\agent.mjs
|
给它一个多轮任务(比如"看看这个目录的结构,再读一下最大的那个文件"),观察每轮统计行:第一轮命中 0%,之后应迅速升到 90%+。对照实验:把 SYSTEM 第一行改成 `当前时间:${new Date().toISOString()}`,重跑同样的任务——命中率归零,直接看到这笔差价。
给本章 agent 加一个 /cost 命令:按你所用服务商的真实价目(命中价、未命中价、输出价)把会话累计花费折算成钱,并对比"如果全部未命中"的假想账单。成本可见,纪律才可验证。
思考题:s06 的压缩把历史整段重写,缓存必然失效一次。压缩的阈值(75%)和缓存之间存在一个权衡:压得越早,缓存失效越频繁;压得越晚,每轮承担的未命中风险越大。如果服务商的缓存保留时间很短(Anthropic 默认 TTL 只有 5 分钟;DeepSeek 是小时级的闲置淘汰),这个权衡又会怎么变?(s09 讲子代理时会再回到"前缀即资产"这个视角。)
③的归因只有两档(TTL / 前缀改写)。给"前缀改写"再往下分:在开发模式下保留最近两轮请求的序列化文本,击穿且 TTL 未过时自动跑一次实验 A–C 那样的字节 diff,把断点落进 system / tools / 历史第几条消息,直接报"凶手是谁"。想清楚为什么这只能是开发模式的功能——生产里留全量 payload 的代价是什么?
练习 1 的答案:/cost 命令#
实现思路(三步)#
- 在 s07 agent.mjs 的
printUsage 旁边加一个会话级账本,把每轮的 miss / hit / output token 累加起来; - 定价做成可配置对象(以实际服务商价目为准),命中价、未命中价、输出价;
- REPL 里拦截
/cost 命令:算实际花费 + “全部未命中"的假想花费,打印对比。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
| // 定价:以你所用服务商实际价目为准,单位:元 / 1M token
// (DeepSeek 命中 ≈ 未命中 1/10;Anthropic cache read 也是 0.1 倍)
const PRICING = { miss: 2.0, hit: 0.2, output: 8.0 };
const ledger = { miss: 0, hit: 0, output: 0 };
// 每轮把 usage 累进账本(复用 s07 的 readCacheUsage 读缓存字段)
function trackLedger(usage) {
const u = readCacheUsage(usage);
ledger.miss += u.miss ?? u.prompt;
ledger.hit += u.hit ?? 0;
ledger.output += usage.completion_tokens ?? 0;
}
function costOf() {
const real =
(ledger.miss * PRICING.miss + ledger.hit * PRICING.hit + ledger.output * PRICING.output) / 1e6;
const allMiss = ((ledger.miss + ledger.hit) * PRICING.miss + ledger.output * PRICING.output) / 1e6;
return { real, allMiss, savedPct: allMiss > 0 ? (1 - real / allMiss) * 100 : 0 };
}
|
REPL 里拦截 /cost(不发给模型):
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
| while (true) {
const line = (await rl.question("\n你> ")).trim();
if (line === "/cost") {
const c = costOf();
console.log(`实际花费 ≈ ¥${c.real.toFixed(4)} | 全未命中假想 ¥${c.allMiss.toFixed(4)} | 省 ${c.savedPct.toFixed(1)}%`);
continue;
}
if (!line) continue;
messages.push({ role: "user", content: line });
await runTurn(messages);
}
|
为什么"成本可见,纪律才可验证”#
缓存纪律是静默的——不报错,只体现在账单上。没有数字,就无从判断一个改动有没有效果。有了 /cost,你可以做对照实验:把时间戳挪出 system 前后各跑一段任务,看那行"实际花费"的差——差出来的,就是这套纪律的钱。
练习 2 的答案:压缩阈值 vs 缓存 TTL#
权衡的基本形状#
- 压得早(阈值低):压缩更频繁 → 缓存失效更频繁(每次压缩 = 一次全价 miss);
- 压得晚(阈值高):每次压缩间隔长,但每轮携带的历史更大 → 一旦前缀断了(TTL 过期 / 任何改写),整段大历史按全价重算。
缓存保留时间短(Anthropic 5 分钟 TTL)时怎么变#
前提先变了:即使不压缩,用户离开 5 分钟再回来,缓存本来就没了——缓存是易碎品,不是长期资产。于是两个理由都指向"压得早更好":
- 压缩牺牲的那个缓存前缀,反正很快就过期——没什么可损失的;
- 不压的话,每轮拖着巨大的历史,一旦 TTL 过期(短 TTL 下频繁发生),整段按全价重算的代价更大;把历史压小,即使全价重算也便宜。
一句话:TTL 越短,缓存越像易碎品,越不值得为它推迟压缩;TTL 越长(DeepSeek 小时级),缓存越是持久资产,越值得压低压缩频率去保住它。
这也回扣 s07③"压缩边界重置追踪器"的意义:压缩那次 miss 是买来的(用一次全价换之后更短的前缀)。TTL 短时这笔买卖更划算——反正缓存也会自己过期。
练习 3 的答案:开发模式的断点归因#
为什么只能是开发模式#
保留每轮全量 payload 有三个代价:
| 代价 | 说明 |
|---|
| 内存 / 磁盘 | 正比于 上下文长度 × 轮数。100k token 的请求 ≈ 几百 KB,长会话几十轮就是几十 MB,还要在内存里留两份做 diff |
| 隐私 / 安全 | 全量对话文本常驻内存/日志 = 泄密面。真实产品连字段名都要避开 /token/i 打码——全量 payload 是更大的靶子 |
| 性能 | 每轮对两份几十万字符做字节 diff,是 O(上下文) 的额外计算,生产里每轮都付不划算 |
开发模式正好相反:低流量、短会话、你要的就是细节。这就是"仪表盘 vs 示波器"的延伸——生产看 ③ 的累计浪费(便宜、安全),开发用字节 diff 精确定位(贵、敏感,但值得)。
实现骨架#
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
| // 开发模式:只保留最近两轮请求的序列化文本
let prevPayload = null;
const DEV = process.env.DEV === "1";
// 拼接 payload 时同时记录每段(system/tools/第 k 条消息)的起始偏移
function buildPayload(messages, tools) { /* 拼接 + 记录偏移表 */ }
// 击穿且 TTL 未过 → 自动定位凶手
if (DEV && miss && !ttlExpired && prevPayload) {
const n = commonPrefixLength(prevPayload, curPayload);
const culprit = locateSection(n); // 把字节偏移映射回 system / tools / 第 k 条消息
console.error(`缓存断点 → ${culprit}(第 ${n} 字节处)`);
}
prevPayload = curPayload;
|
locateSection 靠段偏移表把断点字节 n 落进具体段;配合 s07③ 的闲置时长,就能报"TTL 未过 + 断点在第 3 条工具消息中间 = 有人改写了历史",而不是一句笼统的"前缀被改写"。
与真实产品对照(延伸阅读)#
计价细节:DeepSeek 的缓存命中输入价约为未命中的 1/10;Anthropic 的 cache read 同样是基础输入价的 0.1 倍,但缓存不自动生效——要在请求里显式打 cache_control 断点,且缓存写入按 1.25 倍计价。只学本章三条纪律、直连 Anthropic 而不打断点,命中率会一直是 0。
用回归测试守住前缀稳定:Reina 为此写了 packages/core/src/engine-prompt.cache-stability.test.ts:把所有每轮会变的状态(todos、计划、笔记、autopilot 进度、记忆块)全部填满,断言 system prompt 一个字节都不变——这些易变状态走另一条通道 buildVolatileContextReminder,作为尾部消息随每轮追加(正是纪律①的"挪到最后")。测试注释说明了它存在的意义:某天有人把一个每轮会变的值接进 buildSystemPrompt 时,让测试显式失败。
③的浪费计数器:Reina 的实现在 packages/core/src/cache-stats.ts(2026-07 从 pi 的 cache-stats 移植,纯函数一共 60 行):trackCacheUsage(prev, usage, now) 返回下一个追踪状态和本轮的 miss,min(prev, curr) - cacheRead 那行公式、1024 的噪声地板、reportedCache 粘性标记、TTL 归因与本节一一对应;压缩边界的重置由引擎在 compaction 完成时清掉追踪状态。累计值进 session.usage.cacheWaste 随会话持久化,UI 的用量弹窗常驻一行 “Cache waste”。与它互补的 diagnoseCachePrefix(stderr 根因诊断)就是练习 3 的方向——一个说多少,一个说为什么。移植时还踩了个真实坑:trace 打点的字段起名 missed 而不是 missedTokens,因为日志脱敏按 /token/i 打码,后者会被涂成星号。
案例:摘要调用复用主 agent 的缓存前缀。s06 的压缩要把整段被压历史发给摘要模型——看起来注定全价:换了 system prompt(摘要指令)、不带 tools,前缀从第一个字节就对不上。一次压缩 = 10 万 token 全价。Reina 的解法(packages/core/src/compaction.ts,搜 SummaryCacheReuse):摘要调用不换 system,直接复用主 agent 刚缓存过的 [system + tools + history] 前缀——被压缩的大段历史按原样作为消息发出(provider 序列化和上一轮逐字节相同),摘要指令作为追加的一条用户消息放在末尾。于是 10 万 token 的历史按缓存读计费,全价的只有末尾几百 token 的指令。代价是一点风险:主 agent 的 system prompt 鼓励用工具,模型可能不做总结而去调工具——所以指令里带上"禁止调用工具"的围栏,一旦模型仍去调工具,立刻放弃、退回换 system 的常规路径重试。最坏情况多花一次几乎全命中的调用,不会拿到降质的摘要。
案例:fork 子代理继承父会话的缓存。多 agent 场景的痛点是冷启动:每个子代理独立的 system + 历史,第一轮全价。Reina 的 fork 模式(packages/core/src/subagent/fork.ts 的 buildForkContext)让子代理直接继承父会话的消息尾部(按 token 预算选,默认 8k、上限 24 条,且刻意停在消息边界上)——子代理的第一轮请求就是"父会话的前缀 + 一条任务指令",第一轮即可命中父缓存。一次 fan-out 的成本是 “supervisor’s prefix + small delta per worker”,而不是 N 次冷启动。子代理的完整机制在 s09 展开,这里先记住:缓存友好是它的初始设计,不是事后补丁。
Claude Code 的实例:它同样遵守这套纪律——system prompt 会话内稳定,动态上下文(文件变更提醒、todo 状态)全部以 <system-reminder> 消息追加在对话尾部,而不是改写 system。transcript 里那些 reminder 的位置,就是纪律①的实例。
粒度与序列化细节:缓存匹配实际按 token 块粒度对齐(DeepSeek 64 token 一块,Anthropic/OpenAI 也有各自的最小长度和断点规则),demo 用字符近似只是为了让断点位置直观可见,原理一致。system 与 tools 在请求前部的先后顺序因服务商而异,Anthropic 是 tools 在前。
会话持久化与恢复#
agent 干了半小时的活:几十轮对话、二十次工具调用。你按错了 Ctrl+C,或终端误关、笔记本没电——重新打开,它什么都不记得。前几章的 agent 都这样:messages 只存在内存里。
常见的第一反应是"存成 JSON 文件,每次变化整个重写"。这个方案有隐患——demo 场景一真实写磁盘、真实模拟崩溃,展示了这个现场:
1
2
3
4
| ━━━ 场景一:全量重写 JSON,崩溃在写到一半时 ━━━
磁盘上留下 124/207 字节的 session.json,尝试恢复:
✗ JSON.parse 失败:Unterminated string in JSON at position 124 (line 7 column 27)
✗ 整个会话报废 —— 不止最后一条消息,之前的历史也一起没了。
|
解决方案#
落盘的不是状态快照,而是事件:每发生一件事就往 JSONL 文件末尾追加一行,已写下的字节永远不被触碰;恢复时逐行重放事件,把 messages 重新推导出来。崩溃的影响从"整个文件可能写坏"缩小到"最后一行可能写了一半"——跳过那行即可:丢一条消息,不丢整个会话。
实现:#
store.mjs#
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
| // 会话落盘 —— 追加式事件日志(JSONL)+ 重放恢复。
//
// 从真实产品 Reina 的 packages/core/src/rollout.ts 简化移植,机制一致:
// · 一个会话一个 <id>.jsonl,每发生一件事 append 一行 { ts, type, ... }
// · 只追加、绝不回写已有字节 —— 崩溃最坏丢最后一行,不会损坏整个会话
// · 恢复 = 逐行重放(replay)重建状态;坏行(半截写入)跳过,其余照常
// · 会话粒度的配置(用的什么模型)记在第一行 session_meta 里,随重放恢复
//
// 事件类型(本章只用三种,真实产品有二十多种):
// session_meta —— 会话头:id、model、createdAt(永远是第一行)
// message —— 一条对话消息(user / assistant / tool,原样保存)
// tool_call —— 一次工具调用的结构化记录 { id, name, input, status }
import { appendFileSync, mkdirSync, readFileSync, readdirSync } from "node:fs";
import path from "node:path";
export function sessionPath(dir, id) {
return path.join(dir, `${id}.jsonl`);
}
/** 新建会话:生成 id,把 session_meta 作为第一行写下去。
* model 在这里被"冻结"进会话 —— 以后恢复时以这一行为准,
* 而不是取恢复那一刻的环境默认值。 */
export function createSession(dir, { model }) {
const id = `ses_${Date.now().toString(36)}_${Math.random().toString(36).slice(2, 6)}`;
const meta = { id, model, createdAt: new Date().toISOString() };
appendEvent(dir, id, { type: "session_meta", meta });
return meta;
}
/** 追加一个事件。appendFileSync 用 "a" 标志打开 —— 操作系统层面的
* O_APPEND:每次写都落在文件末尾,永远不触碰已有内容。
* (Reina 为了性能和写入顺序保证,会常驻一个文件句柄并用 Promise
* 链串行化写入;示例版每次重开,崩溃安全性完全一样。) */
export function appendEvent(dir, id, event) {
mkdirSync(dir, { recursive: true });
const line = JSON.stringify({ ts: new Date().toISOString(), ...event });
appendFileSync(sessionPath(dir, id), line + "\n");
}
/** 恢复 = 重放:逐行读事件,重建 { meta, messages, toolCalls }。
* 解析失败的行(多半是崩溃时写了一半的最后一行)跳过并计数 ——
* 丢一行,不丢整个会话。文件不存在或没有 session_meta 返回 null。 */
export function replaySession(dir, id) {
let text;
try {
text = readFileSync(sessionPath(dir, id), "utf8");
} catch {
return null;
}
let meta = null;
const messages = [];
const toolCalls = [];
let skipped = 0;
for (const raw of text.split("\n")) {
const line = raw.trim();
if (!line) continue;
let event;
try {
event = JSON.parse(line);
} catch {
skipped++; // 半截行:跳过,别让一行坏数据毁掉全部历史
continue;
}
switch (event.type) {
case "session_meta":
meta = event.meta;
break;
case "message":
messages.push(event.message);
break;
case "tool_call": {
// 按 id upsert:同一次调用的后续更新(如 running → completed)覆盖前一条。
const i = toolCalls.findIndex((r) => r.id === event.record.id);
if (i === -1) toolCalls.push(event.record);
else toolCalls[i] = { ...toolCalls[i], ...event.record };
break;
}
default:
// 未知事件类型(来自新版本写的日志):忽略,老代码也能加载新会话。
break;
}
}
if (!meta) return null;
return { meta, messages, toolCalls, skipped };
}
/** 列出目录下已有的会话 id(给 --resume 提示用)。 */
export function listSessionIds(dir) {
let entries;
try {
entries = readdirSync(dir);
} catch {
return [];
}
return entries.filter((f) => f.endsWith(".jsonl")).map((f) => f.slice(0, -".jsonl".length));
}
|
agent.mjs#
  1
  2
  3
  4
  5
  6
  7
  8
  9
 10
 11
 12
 13
 14
 15
 16
 17
 18
 19
 20
 21
 22
 23
 24
 25
 26
 27
 28
 29
 30
 31
 32
 33
 34
 35
 36
 37
 38
 39
 40
 41
 42
 43
 44
 45
 46
 47
 48
 49
 50
 51
 52
 53
 54
 55
 56
 57
 58
 59
 60
 61
 62
 63
 64
 65
 66
 67
 68
 69
 70
 71
 72
 73
 74
 75
 76
 77
 78
 79
 80
 81
 82
 83
 84
 85
 86
 87
 88
 89
 90
 91
 92
 93
 94
 95
 96
 97
 98
 99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
218
219
220
221
222
223
224
225
226
227
228
229
230
231
232
233
234
235
236
237
238
239
240
241
242
243
244
245
246
247
248
249
250
251
252
253
254
255
256
257
258
259
260
261
262
263
264
| #!/usr/bin/env node
// s08 —— 会话落盘与恢复:s03 的 agent + 追加式事件日志(store.mjs)。
//
// 新增的全部内容:
// · 每条消息进 messages 数组的同时 append 一行事件到 .sessions/<id>.jsonl
// · 工具调用带结构化 status 落盘(回收 s03 靠报错文案前缀判失败的临时方案)
// · 启动带 --resume <id> → 重放事件重建 messages,续上次的会话接着聊
// · 会话用的模型记录在 session_meta 里,恢复时以它为准,不取当前默认
//
// 运行:AGENT_API_KEY=sk-xxx node agent.mjs # 新会话,打印会话 id
// AGENT_API_KEY=sk-xxx node agent.mjs --resume <id> # 断了接上
import readline from "node:readline/promises";
import { execSync } from "node:child_process";
import { readFileSync, writeFileSync, mkdirSync } from "node:fs";
import path from "node:path";
import { LoopBudget, isRecoverable, repairPrompt } from "./loop-budget.mjs";
import { appendEvent, createSession, listSessionIds, replaySession, sessionPath } from "./store.mjs";
const BASE_URL = process.env.AGENT_BASE_URL ?? "https://api.deepseek.com/v1";
const API_KEY = process.env.AGENT_API_KEY;
if (!API_KEY) {
console.error("缺少 AGENT_API_KEY。任何 OpenAI 兼容的 key 都行(DeepSeek / Kimi / GLM / OpenRouter / 本地 Ollama)。");
process.exit(1);
}
// ─── 会话:新建或恢复 ─────────────────────────────────────────────────────
const SESSIONS_DIR = path.join(process.cwd(), ".sessions");
const resumeAt = process.argv.indexOf("--resume");
const resumeId = resumeAt !== -1 ? process.argv[resumeAt + 1] : undefined;
let meta;
const messages = [];
if (resumeId) {
const restored = replaySession(SESSIONS_DIR, resumeId);
if (!restored) {
console.error(`找不到会话 ${resumeId}。可用的会话:${listSessionIds(SESSIONS_DIR).join("、") || "(无)"}`);
process.exit(1);
}
meta = restored.meta;
messages.push(...restored.messages);
console.log(
`已恢复会话 ${meta.id}:${restored.messages.length} 条消息,${restored.toolCalls.length} 次工具调用` +
(restored.skipped ? `(跳过 ${restored.skipped} 行损坏数据)` : ""),
);
} else {
// 模型在"创建时"读一次环境变量,然后冻结进 session_meta ——
// 恢复这个会话的永远是它,而不是恢复那一刻的默认值。
meta = createSession(SESSIONS_DIR, { model: process.env.AGENT_MODEL ?? "deepseek-chat" });
console.log(`新会话 ${meta.id}(落盘于 ${sessionPath(SESSIONS_DIR, meta.id)})`);
console.log(`下次续上:node agent.mjs --resume ${meta.id}`);
}
const MODEL = meta.model; // 会话粒度的配置,来自会话记录
/** 消息只从这里进数组:内存 + 磁盘一步完成,两边永远一致。 */
function pushMessage(message) {
messages.push(message);
appendEvent(SESSIONS_DIR, meta.id, { type: "message", message });
}
const SYSTEM = `你是一个运行在用户终端里的编程助手。
优先用专用工具(read_file / write_file / edit_file)操作文件;run_shell 用于其余一切。
先观察真实世界再行动,不要凭空猜测文件内容。
当前目录:${process.cwd()}
操作系统:${process.platform}`;
// ─── 工具注册表(s02/s03 的四件套,失败改为 throw —— 见 dispatch)────────
const REGISTRY = {
run_shell: {
description: "在用户的终端里执行一条 shell 命令,返回 stdout 和 stderr。",
parameters: {
type: "object",
properties: { command: { type: "string", description: "要执行的命令" } },
required: ["command"],
},
handler: ({ command }) => {
console.log(`\x1b[33m $ ${command}\x1b[0m`);
try {
const out = execSync(command, {
encoding: "utf8",
timeout: 30_000,
maxBuffer: 1024 * 1024,
stdio: ["ignore", "pipe", "pipe"],
});
return out.trim() || "(命令执行成功,无输出)";
} catch (err) {
// 失败 = 抛异常。报错文案原样保留(错误即信息,模型看得到),
// 但"这次调用失败了"这个事实由 dispatch 转成结构化 status。
throw new Error(`命令失败(exit ${err.status ?? "?"}):\n${err.stdout ?? ""}${err.stderr ?? err.message}`);
}
},
},
read_file: {
description: "读取一个文本文件,返回带行号的内容。",
parameters: {
type: "object",
properties: { path: { type: "string", description: "文件路径(相对或绝对)" } },
required: ["path"],
},
handler: ({ path: p }) => {
console.log(`\x1b[33m read ${p}\x1b[0m`);
const text = readFileSync(p, "utf8"); // 读不到 → 自然抛出,dispatch 记 failed
const CAP = 50_000;
const body = text.length > CAP ? text.slice(0, CAP) + `\n…(截断,共 ${text.length} 字符)` : text;
return body
.split("\n")
.map((line, i) => `${String(i + 1).padStart(4)}\t${line}`)
.join("\n");
},
},
write_file: {
description: "写入一个文件(整体覆盖)。父目录不存在时自动创建。",
parameters: {
type: "object",
properties: {
path: { type: "string", description: "文件路径" },
content: { type: "string", description: "完整的文件内容" },
},
required: ["path", "content"],
},
handler: ({ path: p, content }) => {
console.log(`\x1b[33m write ${p} (${content.length} 字符)\x1b[0m`);
mkdirSync(path.dirname(path.resolve(p)), { recursive: true });
writeFileSync(p, content);
return `已写入 ${p}`;
},
},
edit_file: {
description:
"对文件做一次精确替换。old_string 必须在文件中出现且仅出现一次(带上足够的上下文来保证唯一),否则会失败。",
parameters: {
type: "object",
properties: {
path: { type: "string", description: "文件路径" },
old_string: { type: "string", description: "要被替换的原文(必须唯一匹配)" },
new_string: { type: "string", description: "替换成的新文本" },
},
required: ["path", "old_string", "new_string"],
},
handler: ({ path: p, old_string, new_string }) => {
console.log(`\x1b[33m edit ${p}\x1b[0m`);
const text = readFileSync(p, "utf8");
const first = text.indexOf(old_string);
if (first === -1) throw new Error(`编辑失败:old_string 在 ${p} 中找不到。请先 read_file 确认原文。`);
if (text.indexOf(old_string, first + 1) !== -1)
throw new Error(`编辑失败:old_string 在 ${p} 中出现多次。请带上更多上下文让它唯一。`);
// 不能用 text.replace(old, new):new_string 里的 $$ / $& 会被 JS 当替换模式展开,静默写坏文件。
writeFileSync(p, text.slice(0, first) + new_string + text.slice(first + old_string.length));
return `已编辑 ${p}`;
},
},
};
const TOOLS = Object.entries(REGISTRY).map(([name, t]) => ({
type: "function",
function: { name, description: t.description, parameters: t.parameters },
}));
// s03 靠 FAILURE_RE 前缀猜成败,本章拆掉这个脚手架:
// 成败在执行的那一刻就确定(return = completed,throw = failed),
// dispatch 把它变成结构化字段,落盘之后审计和重放都不用再解析报错文案。
function dispatch(call) {
const tool = REGISTRY[call.function.name];
if (!tool) return { status: "failed", output: `未知工具:${call.function.name}` };
let args;
try {
args = JSON.parse(call.function.arguments || "{}");
} catch (err) {
return { status: "failed", output: `工具参数不是合法 JSON:${err.message}` };
}
try {
return { status: "completed", output: tool.handler(args) };
} catch (err) {
return { status: "failed", output: err.message }; // 错误依旧作为文本回给模型
}
}
// ─── 主循环:s03 原样 + 每一步落盘 ───────────────────────────────────────
async function chat(msgs) {
const res = await fetch(`${BASE_URL}/chat/completions`, {
method: "POST",
headers: {
"content-type": "application/json",
authorization: `Bearer ${API_KEY}`,
},
body: JSON.stringify({
model: MODEL,
messages: [{ role: "system", content: SYSTEM }, ...msgs],
tools: TOOLS,
}),
});
if (!res.ok) throw new Error(`API ${res.status}:${await res.text()}`);
const data = await res.json();
return data.choices[0].message;
}
async function runTurn() {
const budget = new LoopBudget({ baseSteps: 12 });
let repaired = false;
while (true) {
if (!budget.canContinue()) {
const stop = budget.exhaustedStop();
console.log(`\n\x1b[31m⛔ ${stop.message}(第 ${stop.turnCount} 轮)\x1b[0m`);
return;
}
const msg = await chat(messages);
pushMessage(msg); // 助手消息(含 tool_calls)落盘
if (msg.content) console.log(`\n${msg.content}`);
if (!msg.tool_calls?.length) return;
const records = [];
for (const call of msg.tool_calls) {
const { status, output } = dispatch(call);
pushMessage({ role: "tool", tool_call_id: call.id, content: output }); // 工具结果落盘
let input = {};
try {
input = JSON.parse(call.function.arguments || "{}");
} catch { /* 坏参数已作为失败回填 */ }
const record = { name: call.function.name, input, status, output };
records.push(record);
// 结构化审计记录:真实产品的 ToolCallRecord 还带 permission / preview /
// outputPath 等字段,这里只落最小集。output 已在 tool 消息里,不重复存。
appendEvent(SESSIONS_DIR, meta.id, {
type: "tool_call",
record: { id: call.id, name: record.name, input, status },
});
}
const stop = budget.recordTurn(records);
if (!stop) continue;
if (isRecoverable(stop) && !repaired) {
repaired = true;
console.log(`\n\x1b[35m🟡 看门狗触发(${stop.reason}),注入纠偏 prompt…\x1b[0m`);
pushMessage({ role: "user", content: repairPrompt(stop) }); // 纠偏也是历史的一部分
continue;
}
console.log(`\n\x1b[31m⛔ ${stop.message}(reason=${stop.reason},第 ${stop.turnCount} 轮)\x1b[0m`);
return;
}
}
const rl = readline.createInterface({ input: process.stdin, output: process.stdout });
console.log(`s08 agent 已上线(${MODEL},来自会话记录)。工具:${Object.keys(REGISTRY).join("、")}。Ctrl+C 随便按 —— 会话在盘上。`);
while (true) {
const line = (await rl.question("\n你> ")).trim();
if (!line) continue;
pushMessage({ role: "user", content: line });
await runTurn();
}
|
demo.mjs#
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
| #!/usr/bin/env node
// 不需要 API key 的落盘演示:在临时目录里真写 JSONL、真模拟崩溃、真重放。
//
// node s08_persistence/demo.mjs
//
// 三个场景:
// 一、"每次全量重写 JSON"在崩溃时留下半个文件 —— 整个会话报废
// 二、追加式事件日志:写几个事件 → 重放 → 重建出 messages 和会话配置
// 三、最后一行写了一半(撕裂写入)—— 跳过那一行,会话照常恢复
import { appendFileSync, mkdtempSync, readFileSync, writeFileSync } from "node:fs";
import { tmpdir } from "node:os";
import path from "node:path";
import { appendEvent, createSession, replaySession, sessionPath } from "./store.mjs";
const dir = mkdtempSync(path.join(tmpdir(), "s08-demo-"));
// ─── 场景一:全量重写 + 崩溃 = 半个文件 ─────────────────────────────────
console.log("━━━ 场景一:全量重写 JSON,崩溃在写到一半时 ━━━");
const snapshot = {
id: "ses_snapshot",
model: "deepseek-chat",
messages: [
{ role: "user", content: "帮我修一下登录页的报错" },
{ role: "assistant", content: "我先看看代码。" },
],
};
const full = JSON.stringify(snapshot, null, 2);
// 模拟崩溃:写盘写到 60% 时断电 —— 磁盘上只有前 60% 的字节。
const torn = full.slice(0, Math.floor(full.length * 0.6));
const snapPath = path.join(dir, "session.json");
writeFileSync(snapPath, torn);
console.log(` 磁盘上留下 ${torn.length}/${full.length} 字节的 session.json,尝试恢复:`);
try {
JSON.parse(readFileSync(snapPath, "utf8"));
console.log(" (不可能走到这里)");
} catch (err) {
console.log(` ✗ JSON.parse 失败:${err.message.split("\n")[0]}`);
console.log(" ✗ 整个会话报废 —— 不止最后一条消息,之前的历史也一起没了。");
}
// ─── 场景二:追加式事件日志 → 重放重建 ──────────────────────────────────
console.log("\n━━━ 场景二:追加式事件日志(JSONL)→ 重放重建 ━━━");
const meta = createSession(dir, { model: "deepseek-chat" });
appendEvent(dir, meta.id, { type: "message", message: { role: "user", content: "帮我修一下登录页的报错" } });
appendEvent(dir, meta.id, {
type: "message",
message: {
role: "assistant",
content: null,
tool_calls: [{ id: "call_1", type: "function", function: { name: "read_file", arguments: '{"path":"login.js"}' } }],
},
});
appendEvent(dir, meta.id, {
type: "tool_call",
record: { id: "call_1", name: "read_file", input: { path: "login.js" }, status: "completed" },
});
appendEvent(dir, meta.id, { type: "message", message: { role: "tool", tool_call_id: "call_1", content: " 1\tconst token = nul;" } });
appendEvent(dir, meta.id, { type: "message", message: { role: "assistant", content: "找到了:nul 是笔误,应该是 null。" } });
const restored = replaySession(dir, meta.id);
console.log(` 重放 ${sessionPath(dir, meta.id)}:`);
console.log(` 模型 = ${restored.meta.model}(来自 session_meta,不是恢复时的默认值)`);
console.log(` 重建出 ${restored.messages.length} 条消息:`);
for (const m of restored.messages) {
const body = m.content ?? `<调用 ${m.tool_calls?.map((c) => c.function.name).join("、")}>`;
console.log(` [${m.role}] ${body}`);
}
console.log(` 工具调用记录:${restored.toolCalls.map((r) => `${r.name}(${r.status})`).join("、")} ← 结构化 status,不用再解析报错文案`);
// ─── 场景三:最后一行撕裂 —— 丢一行,不丢会话 ───────────────────────────
console.log("\n━━━ 场景三:崩溃把最后一行写了一半 ━━━");
// 模拟崩溃:一条正常事件只落了前半截字节(没有换行、JSON 没闭合)。
const half = JSON.stringify({ ts: new Date().toISOString(), type: "message", message: { role: "user", content: "再帮我加个记住密码" } });
appendFileSync(sessionPath(dir, meta.id), half.slice(0, Math.floor(half.length / 2)));
console.log(` 往同一个 .jsonl 追加了半行(${Math.floor(half.length / 2)}/${half.length} 字节),再次重放:`);
const again = replaySession(dir, meta.id);
console.log(` ✓ 恢复出 ${again.messages.length} 条消息,跳过 ${again.skipped} 行损坏数据`);
console.log(` ✓ 只丢了崩溃瞬间那一条,之前的全部历史完好。`);
console.log(`
结论:
· 全量重写 JSON:崩在写盘中间 = 新旧两份都没了,恢复无从谈起。
· 追加式 JSONL:已写下的字节永远不被触碰,崩溃的爆炸半径被压缩到"最后一行"。
· 恢复 = 重放:状态是从事件流里推出来的,会话配置(模型)也在流里,一起回来。
(演示文件在 ${dir},可以 cat 看看每一行长什么样。)
`);
|
① 为什么"每次全量重写 JSON"不可靠#
写文件不是原子操作。writeFileSync(f, bigJson) 在操作系统层面是"打开(清空旧内容)→ 分块写入字节"。崩溃落在中间,磁盘上就是半个 JSON:旧版本已清空,新版本没写完——JSON.parse 失败,整个会话(包括崩溃前完好的部分)一起丢失。演示场景一就是这个现场。
而且越用越危险:会话越长,重写窗口越大,中招概率越高——最有价值的长会话恰恰最容易被写坏。
追加式日志(JSONL:一行一个 JSON)从结构上消除了这个问题:
1
2
3
| {"ts":"…","type":"session_meta","meta":{"id":"ses_x","model":"deepseek-chat",…}}
{"ts":"…","type":"message","message":{"role":"user","content":"帮我修一下登录页"}}
{"ts":"…","type":"tool_call","record":{"id":"call_1","name":"read_file","status":"completed",…}}
|
每发生一件事(用户消息/助手消息/工具结果/压缩边界)就在末尾追加一行,已写下的字节永远不被触碰。崩溃的影响被限制在"最后一行可能写了一半"——恢复时跳过那行即可:丢一条消息,不丢整个会话。这不是额外的容错,是"只追加"结构自带的性质。
② 恢复 = 重放:状态是事件流的推导结果#
落盘的是事件,不是状态。恢复时逐行读事件,把 messages 数组重新推导出来:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
| for (const line of text.split("\n")) {
if (!line.trim()) continue; // 文件末尾的换行会产生空串,先跳过
let event;
try { event = JSON.parse(line); } catch { skipped++; continue; } // 半截行:跳过
switch (event.type) {
case "session_meta": meta = event.meta; break;
case "message": messages.push(event.message); break;
case "tool_call": /* 按 id upsert 进 toolCalls */ break;
default: break; // 未知类型忽略 —— 老代码也能加载新版本写的日志
}
}
|
这个结构带来两个不显眼但重要的自由度:坏行可以跳过(容错);未知事件类型可以忽略(向前兼容——新版本程序写的日志,旧程序照样能加载它认识的部分)。
③ 会话粒度的配置也在流里#
恢复会话时,模型配置从哪来?很多实现顺手用当前的环境变量或全局默认。这是错的:用什么模型是这个会话自己的属性,创建时就冻结进第一行 session_meta,恢复时以它为准:
1
2
3
| meta = createSession(SESSIONS_DIR, { model: process.env.AGENT_MODEL ?? "deepseek-chat" });
// ……第二天恢复时:
const MODEL = restored.meta.model; // 来自会话记录,不是今天的默认值
|
配置跟着会话走,界面显示和实际请求才不会不一致(真实产品踩过事故,见文末)。
④ 工具调用带结构化 status 落盘#
s03 有个临时方案:靠报错文案的开头文字(FAILURE_RE)判断工具调用是否成功。文案是写给模型看的,随时会改——拿它当机器判据太脆。本章移除这个脚手架:成败在执行那一刻确定,作为结构化字段落盘。
约定很简单:handler return = completed,throw = failed;报错文案原样回给模型(错误即信息),但"失败了"这个事实走字段:
1
2
3
4
5
| try {
return { status: "completed", output: tool.handler(args) };
} catch (err) {
return { status: "failed", output: err.message };
}
|
落盘的 tool_call 事件带着这个 status。从此审计、重放、监督逻辑都读字段,不再解析文案。
运行:#
免 key 演示:
1
| node .\02-上下文缓存与记忆\s08_persistence\demo.mjs
|
三个场景全部真实写磁盘、真实模拟崩溃。场景三的输出节选:
1
2
3
4
| ━━━ 场景三:崩溃把最后一行写了一半 ━━━
往同一个 .jsonl 追加了半行(49/98 字节),再次重放:
✓ 恢复出 4 条消息,跳过 1 行损坏数据
✓ 只丢了崩溃瞬间那一条,之前的全部历史完好。
|
接上真实模型,启动时分岔:带 --resume <id> 就重放恢复,否则开新会话并打印 id:
1
2
3
4
| $env:AGENT_API_KEY = "sk-xxx"
node .\02-上下文缓存与记忆\s08_persistence\agent.mjs
# 新会话 ses_xxxx(落盘于 …/.sessions/ses_xxxx.jsonl),下次续上:
node .\02-上下文缓存与记忆\s08_persistence\agent.mjs --resume ses_xxxx
|
验收:跟它聊两轮、让它读个文件,Ctrl+C 退出,再 --resume 回来问"刚才聊到哪了"——它应该答得上来。s03 看门狗注入的纠偏消息也走 pushMessage:恢复出的会话必须和退出前一致。
给 store.mjs 加一个 compacted 事件和对应的重放逻辑:记录"从第 N 条消息之前已被压缩为摘要 S",重放时用摘要替换被压缩的区间。s06 的压缩机制落盘之后,才算完整闭环。
思考题:demo 场景三里半截行恰好在文件末尾,跳过它显然安全。但如果坏行出现在文件中间(比如磁盘坏块),跳过一条 message 可能让后面的 tool 消息变成"孤儿"(tool_call_id 对不上助手消息)——API 会拒绝这样的序列。恢复时该怎么检测并修剪这种断链?(提示:s05 处理 Ctrl+C 留下的残缺消息序列用的是同一套办法。)
练习 1 的答案:compacted 事件#
新增事件类型 compacted,记录"本次压缩把最前面的 N 条消息替换成摘要 S"。压缩永远发生在中段开头(s06 的三段式:中段 = 最旧的部分),所以重放规则是:遇到 compacted 事件时,把 messages 里最前面的 before 条移除,换成摘要消息。
store.mjs:重放分支加一个 case#
1
2
3
4
5
6
| case "compacted": {
// 压缩区永远在消息流最前面:移除最前面的 before 条,换成摘要消息
const summary = { role: "user", content: `[上下文压缩] ${event.summary}` };
messages.splice(0, event.before, summary);
break;
}
|
agent.mjs:压缩完成后把事件落盘#
1
2
3
4
5
6
7
8
| // s06 的 maybeCompact 里,压缩完成后:
const { messages: newMsgs, dropped } = result;
appendEvent(SESSIONS_DIR, meta.id, {
type: "compacted",
before: dropped, // 被压缩掉的条数
summary: newMsgs[0].content, // 摘要消息(含 [上下文压缩] 前缀)
});
messages.splice(0, messages.length, ...newMsgs);
|
两个要点#
- 为什么是"移除最前面 N 条"而不是"移除最后 N 条":压缩总是从消息流开头动手(s06 三段式:中段 = 最旧部分)。事件日志是时序的,重放到 compacted 事件时,messages 数组 = 该时刻之前所有消息 = [中段, 尾部],中段恰好在最前面。
- 向前兼容的甜头:事件从不删除,老代码就算不认识
compacted 事件(default 分支忽略),也能重放出一份未压缩的完整历史——还是可用会话,只是更费 token。加了 compacted 处理,恢复出的视图才和退出前一致。
练习 2 的答案:坏行断链的检测与修剪#
坏行在文件中间,跳过它可能让 assistant(tool_calls) 或 tool 结果丢失,剩下的序列出现两种残缺:
- 孤儿 tool 消息:tool_call_id 在整段历史里找不到任何 assistant 声明(声明它的那条被坏行吞了)——留着会让 API 400;
- 悬空调用:assistant 声明了 tool_calls,但结果缺失。
检测 = 双向配平(s05 的同一套办法)#
协议约束没变:assistant(tool_calls) 和它的 tool 结果必须配对。s05 处理"中断撕开"的残缺序列,这里处理"日志坏块撕开"的残缺序列——本质都是补配平。重放结束后做两次扫描:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
| // 第一次:收集所有被声明的 tool_call_id(来自 assistant 消息的 tool_calls)
const declared = new Set(
messages
.filter((m) => m.role === "assistant" && m.tool_calls?.length)
.flatMap((m) => m.tool_calls.map((c) => c.id)),
);
const answered = new Set(messages.filter((m) => m.role === "tool").map((m) => m.tool_call_id));
// 修剪:孤儿 tool 消息丢掉
const clean = messages.filter((m) => m.role !== "tool" || declared.has(m.tool_call_id));
const skipped = messages.length - clean.length;
// 悬空调用交给 s05 的 repairDanglingToolCalls 回填合成结果(或整条丢弃,产品取舍)
|
两种残缺的处置#
| 残缺 | 处置 | 为什么 |
|---|
| 孤儿 tool 消息 | 丢弃 | 协议要求 tool 消息必须紧跟发起的 assistant,没有声明 = 无法配对 = 400 |
| 悬空调用 | 回填合成结果(s05 的 repairDanglingToolCalls)或整条丢弃 | 二选一是产品取舍——回填保留上下文,丢弃更干净但可能丢信息 |
与 s05 的区别#
s05 的缺口在末尾(中断只会停在最后),回填即可;坏块可能在中间,两边都可能缺——所以这里要多一步"丢孤儿"。demo 场景三说"半截行在末尾,跳过安全"——这道题就是问"不在末尾怎么办",答案就是配平修剪。
与真实产品对照(延伸阅读)#
本章机制对应 Reina 的 packages/core/src/rollout.ts(参照 openai/codex 的 rollout recorder 建模):每个会话一个 .reina/sessions/<id>.jsonl,每次状态变化 append 一行 { ts, type, ... }。示例版三种事件类型,生产版二十多种(message / tool_call / tool_update / compacted / usage / todos……)。几个值得参考的生产细节:
- 不变量写在注释里:“Writes are
O_APPEND only. No code path ever rewrites an existing byte”——跨进程的并发写者也无法互相覆盖历史。进程内则常驻一个文件句柄、用 Promise 链串行化所有 append(示例版每次重开文件,崩溃安全性一样,性能差一些)。 - 重放跳过坏行:
loadRolloutAsSession 对每行单独 JSON.parse,失败(“likely a torn final write from a crash”)就跳过并告警 skipped N malformed line(s)——和本章 demo 场景三相同。 - 工具调用是结构化记录:
packages/protocol/src/index.ts 的 ToolCallRecord 带 status: "pending_approval" | "running" | "completed" | "rejected" | "failed"——比示例版的两态多出审批流和运行中;还有 outputPath 指向 .reina/tool_outputs/ 下的完整输出存档。 - 决定③的真实事故:Reina 曾在加载旧会话时,模型选择器显示新会话的默认值,而不是会话真正在用的(重放恢复出来的)模型——一个绑定了订阅的会话看起来像在用普通 API key,请求 401,用户以为是配置错误,排查了很久。模型配置随会话重放之外,还有一个细节:
config 事件对 model 是整体替换而非浅合并——浅合并会让上一个模型的 baseUrl 泄漏到切换后的模型上,Reina 注释里记着一次真实事故:kimi 切 codex 后残留的 baseUrl 把请求路由到了错误的主机。 - 仅有的"全量重写"出现在迁移旧格式时(
migrateJsonSnapshotToJsonl),而且写法是先写临时文件再 rename 进位——rename 在同一文件系统上是原子的,崩溃也不会留下半个 jsonl。
另一个可观察的例子:Claude Code 的会话也是 JSONL(~/.claude/projects/<项目>/**.jsonl),--resume 的底层就是同一套重放事件流。
