信息标记的三种形式#
信息的标记#
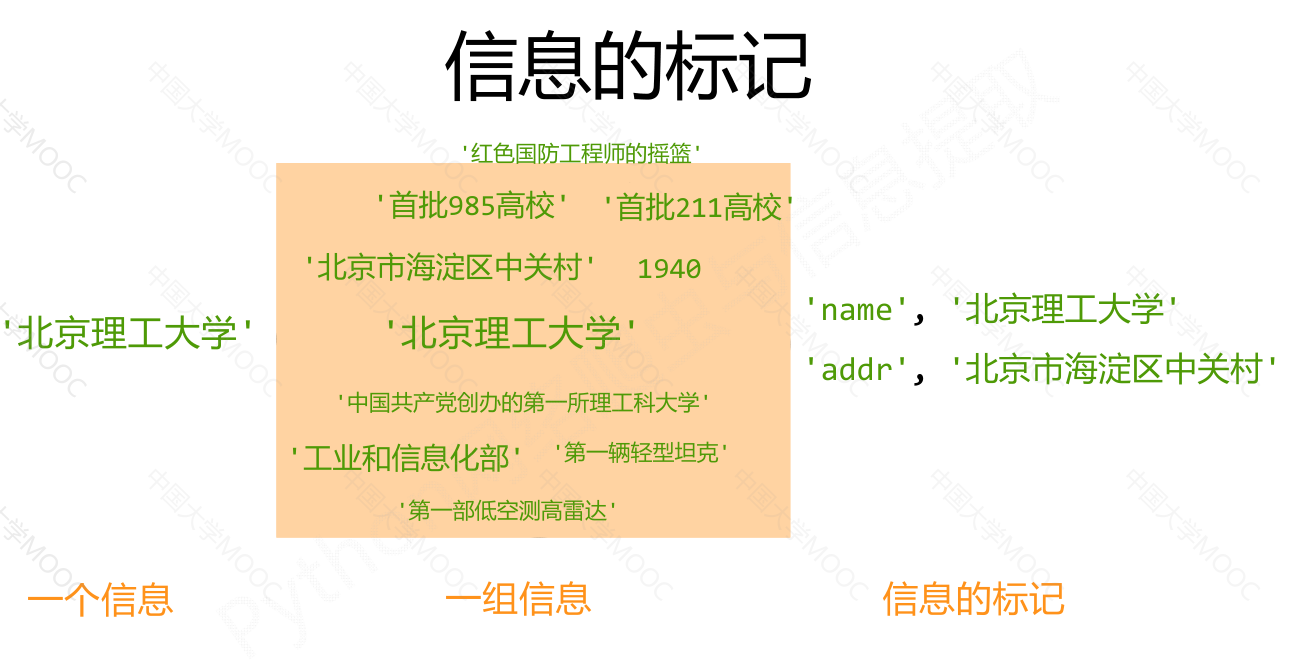
标记后的信息可形成信息组织结构,增加了信息维度
标记的结构与信息一样具有重要价值
标记后的信息可用于通信、存储或展示
标记后的信息更利于程序理解和运用
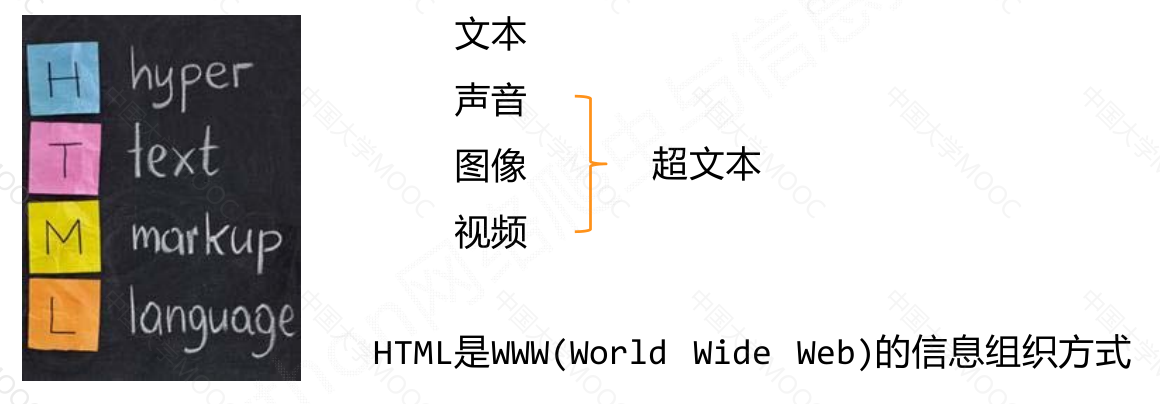
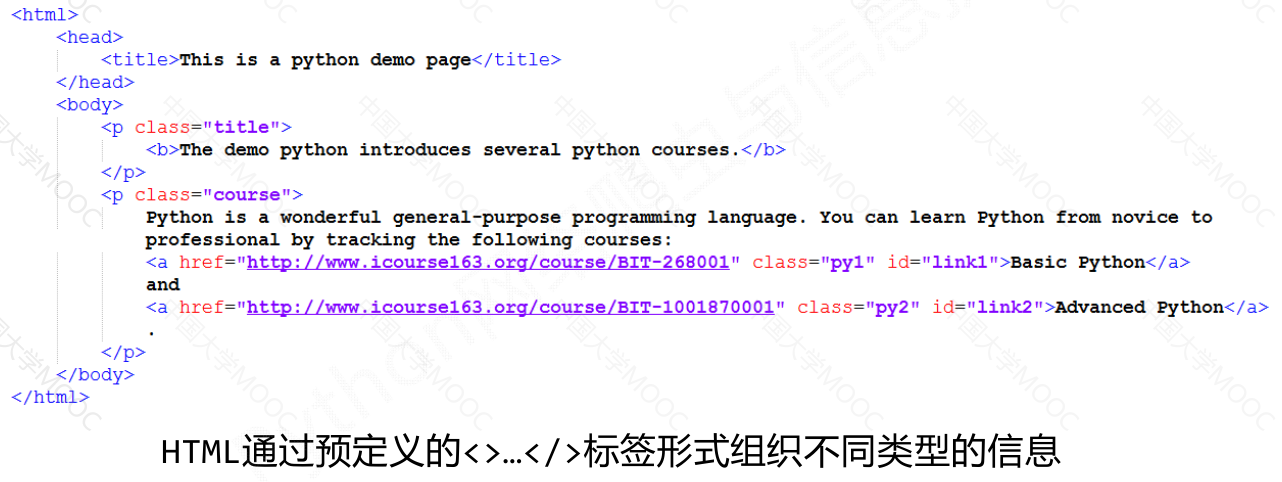
HTML 的信息标记#
信息标记的三种形式#
XML#
eXtensible Markup Language
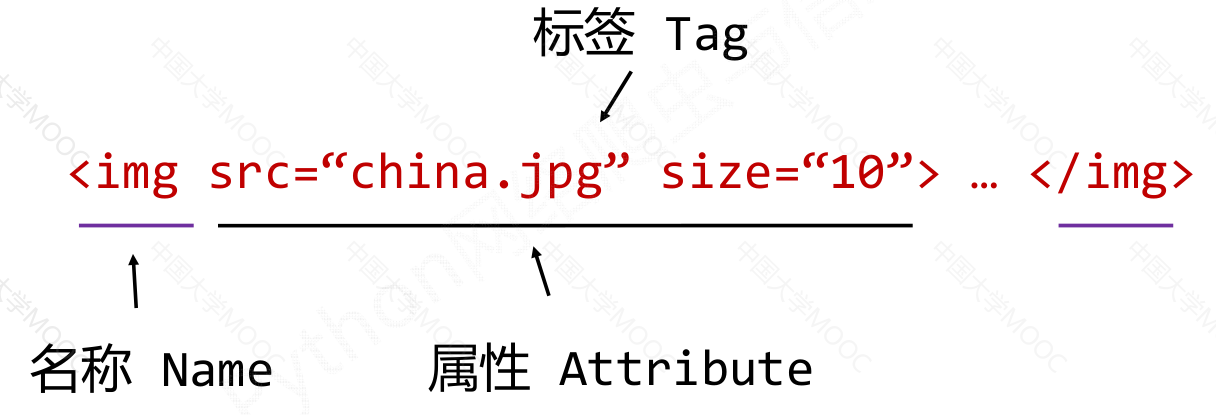
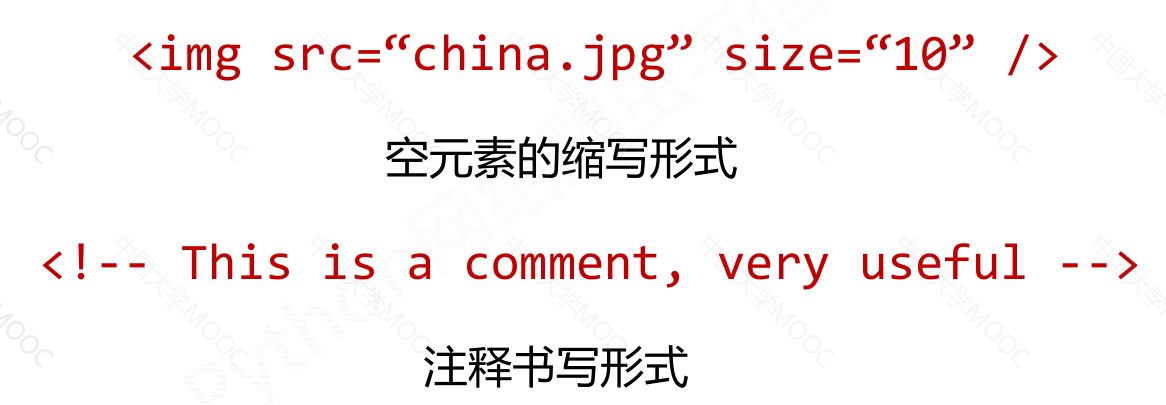
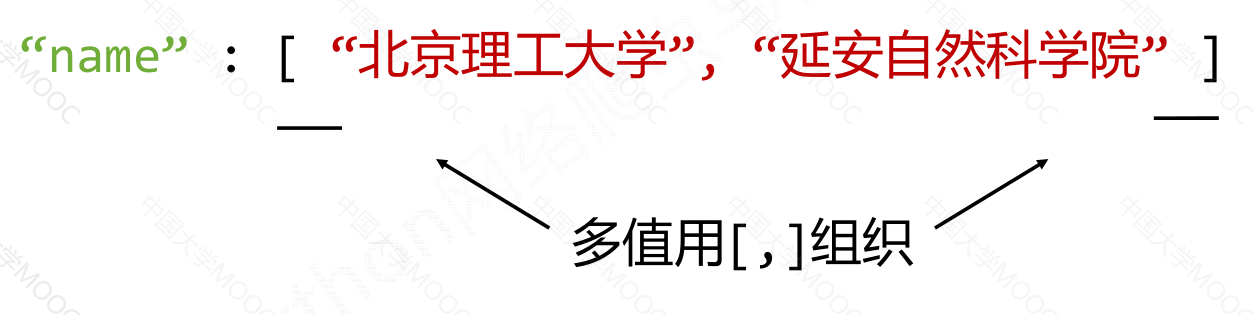
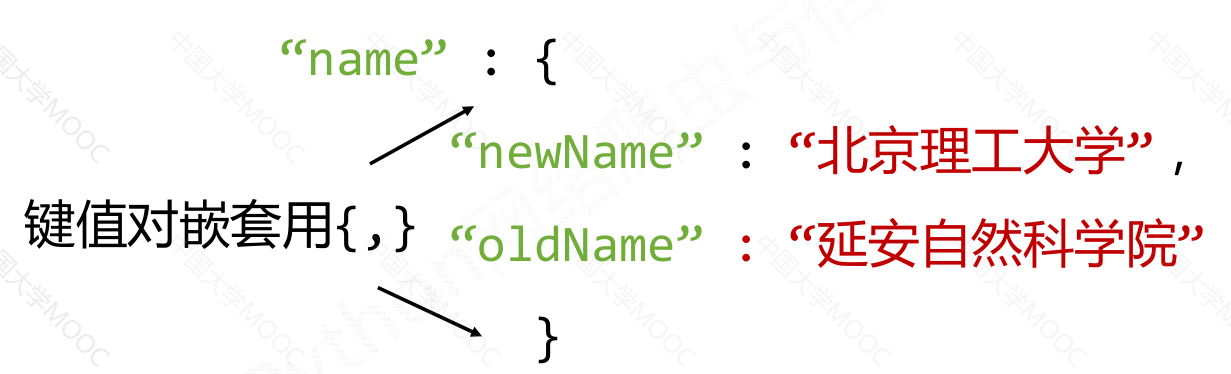
JSON#
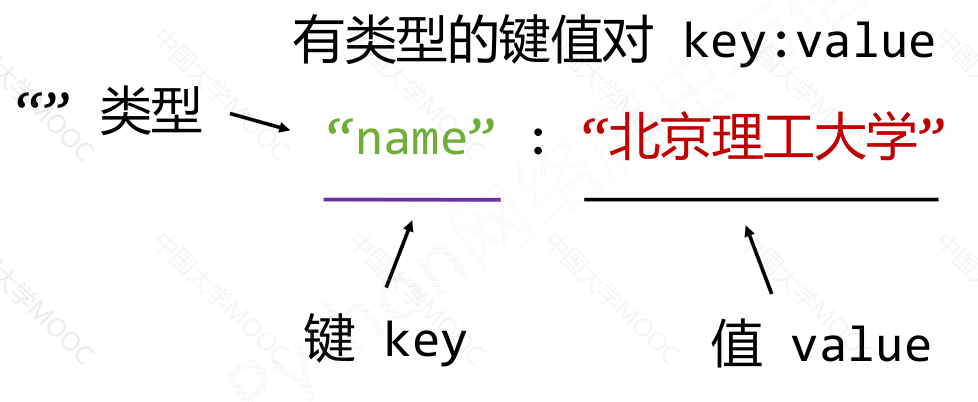
JavsScript Object Notation
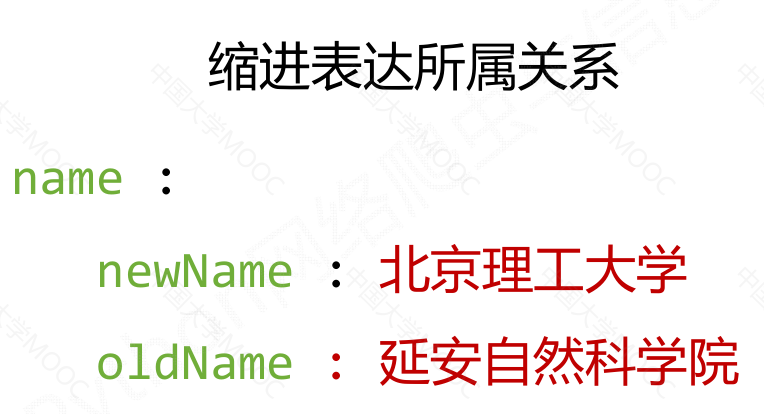
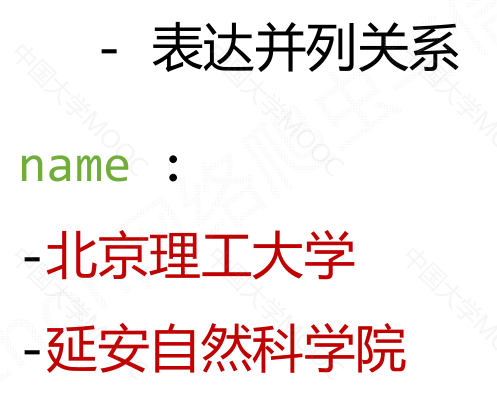
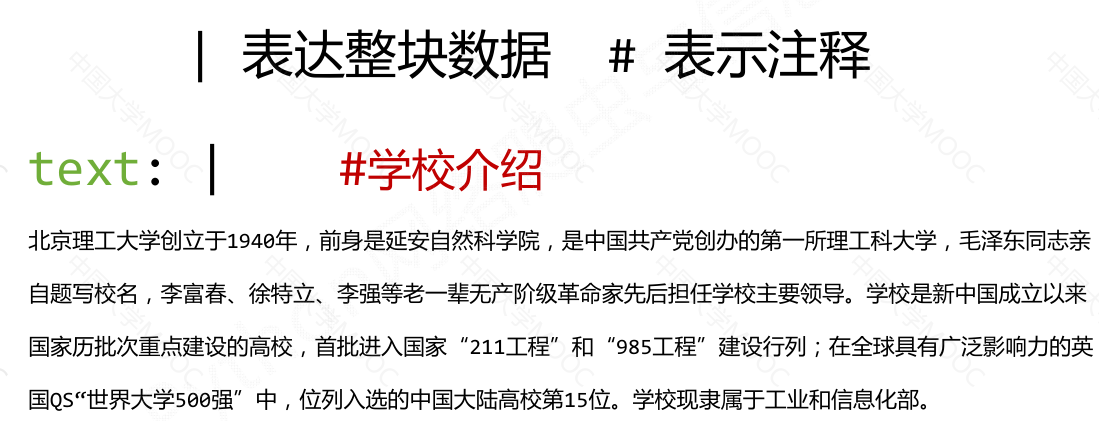
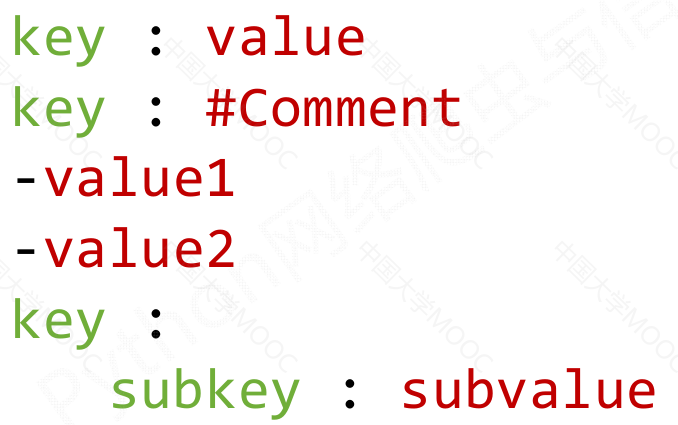
YAML#
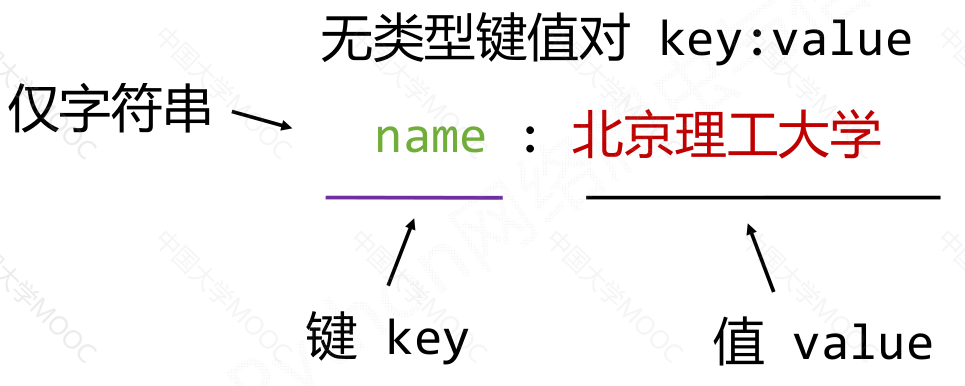
YAML Ain’t Markup Language
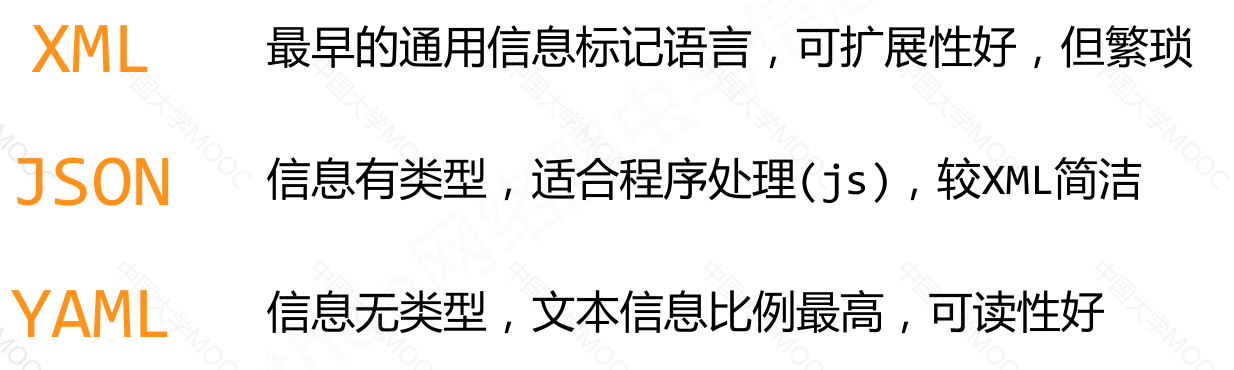
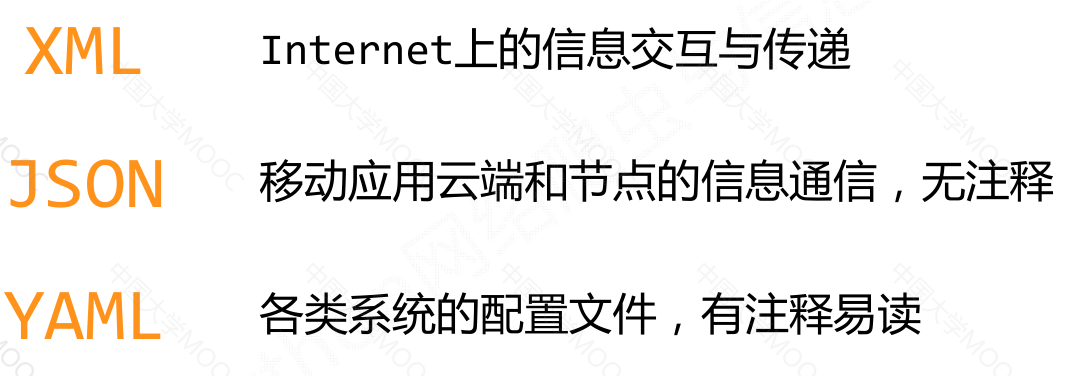
小结&比较#
XML:#
1
2
3
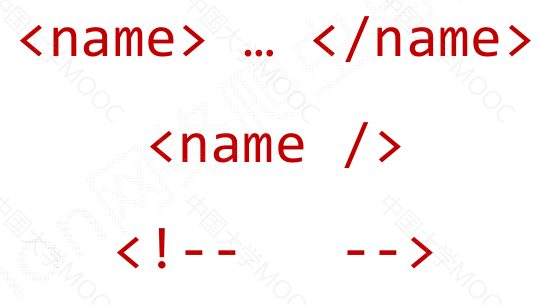
| <name>...</name>
<name/>
<!-- -->
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
| <person>
<firstName>Tian</firstName>
<lastName>Song</lastName>
<address>
<streetAddr>中关村南大街5号</streetAddr>
<city>北京市</city>
<zipcode>100081</zipcode>
</address>
<prof>Computer System</prof><prof>Security</prof>
</person>
|
JSON:#
1
2
3
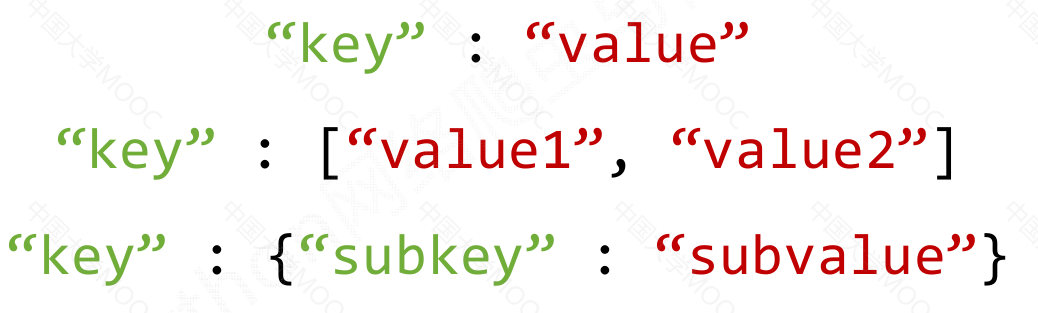
| "key" : "value"
"key" : ["value1", "value2"]
"key" : {"subkey" : "subvalue"}
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
| {
"firstName” : "Tian” ,
"lastName” : "Song” ,
"address” : {
"streetAddr” : "中关村南大街5号” ,
"city" : "北京市” ,
"zipcode” : "100081”
} ,
"prof” : [ "Computer System” , "Security” ]
}
|
YAML:#
1
2
3
4
5
6
| key : value
key : #Comment
-value1
-value2
key :
subkey :subvalue
|
1
2
3
4
5
6
7
8
9
| firstName : Tian
lastName : Song
address:
streetAddr : 中关村南大街5号
city: 北京市
zipcode: 100081
prof:
‐Computer System
‐Security
|
信息提取的一般方法#
方法一:完整解析信息的标记形式,再提取关键信息#
XML JSON YAML
需要标记解析器,例如:bs4库的标签树遍历
优点:信息解析准确
缺点:提取过程繁琐,速度慢
方法二:无视标记形式,直接搜索关键信息#
搜索
对信息的文本查找函数即可
优点:提取过程简洁,速度较快
缺点:提取结果准确性与信息内容相关
融合方法:结合形式解析与搜索方法,提取关键信息#
XML JSON YAML 搜索
需要标记解析器及文本查找函数
实例:#
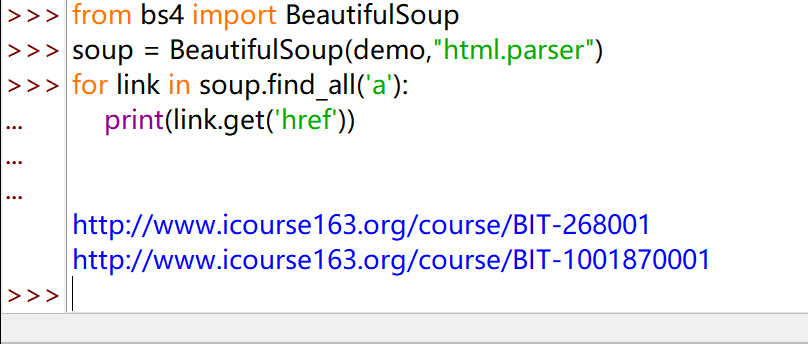
提取 HTML 中所有 URL 链接
思路:1)搜索到所有<a>标签
2)解析`<a>`标签格式,提取`href`后的链接内容
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
| import requests
r = requests.get("http://python123.io/ws/demo.html")
demo = r.text
from bs4 import BeautifulSoup
soup = BeautifulSoup(demo,"html.parser")
for link in soup.find_all('a'):
print(link.get('href'))
http://www.icourse163.org/course/BIT-268001
http://www.icourse163.org/course/BIT-1001870001
|
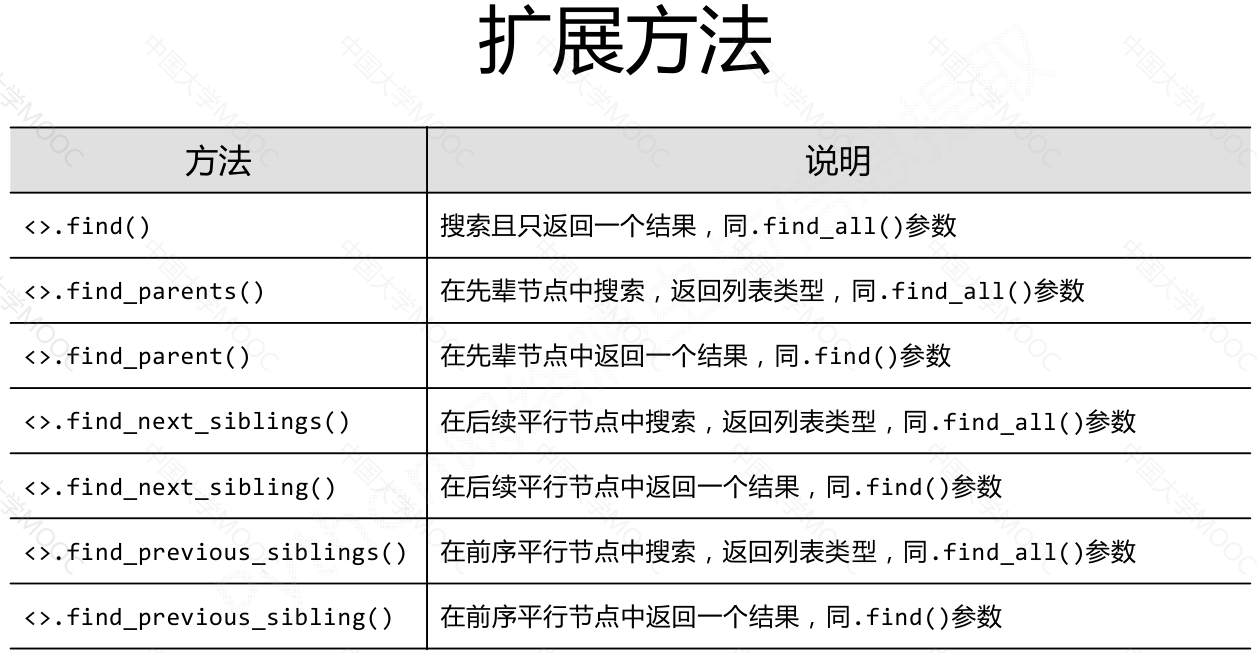
基于 bs4 库的 HTML 内容查找方法#
<>.find_all(name, attrs, recursive, string, **kwargs)
返回一个列表类型,存储查找的结果
name:对标签名称的检索字符串attrs:对标签属性值的检索字符串,可标注属性检索recursive:是否对子孙全部检索,默认Truestring:<>…</>中字符串区域的检索字符串
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
| soup.find_all('a')
[<a class="py1" href="http://www.icourse163.org/course/BIT-268001" id="link1">Basic Python</a>, <a class="py2" href="http://www.icourse163.org/course/BIT-1001870001" id="link2">Advanced Python</a>]
soup.find_all(['a', 'b'])
[<b>The demo python introduces several python courses.</b>, <a class="py1" href="http://www.icourse163.org/course/BIT-268001" id="link1">Basic Python</a>, <a class="py2" href="http://www.icourse163.org/course/BIT-1001870001" id="link2">Advanced Python</a>]
for tag in soup.find_all(True):
print(tag.name)
html
head
title
body
p
b
p
a
a
import re
for tag in soup.find_all(re.compile('b')):
print(tag.name)
body
b
soup.find_all(id='link')
[]
soup.find_all(id=re.compile('link'))
[<a class="py1" href="http://www.icourse163.org/course/BIT-268001" id="link1">Basic Python</a>, <a class="py2" href="http://www.icourse163.org/course/BIT-1001870001" id="link2">Advanced Python</a>]
soup.find_all('a')
[<a class="py1" href="http://www.icourse163.org/course/BIT-268001" id="link1">Basic Python</a>, <a class="py2" href="http://www.icourse163.org/course/BIT-1001870001" id="link2">Advanced Python</a>]
soup.find_all('a', recursive=False)
[]
soup
<html><head><title>This is a python demo page</title></head>
<body>
<p class="title"><b>The demo python introduces several python courses.</b></p>
<p class="course">Python is a wonderful general-purpose programming language. You can learn Python from novice to professional by tracking the following courses:
<a class="py1" href="http://www.icourse163.org/course/BIT-268001" id="link1">Basic Python</a> and <a class="py2" href="http://www.icourse163.org/course/BIT-1001870001" id="link2">Advanced Python</a>.</p>
</body></html>
soup.find_all(sring='Basic Python')
[]
soup.find_all(string='Basic Python')
['Basic Python']
soup.find_all(string=re.compile('python'))
['This is a python demo page', 'The demo python introduces several python courses.']
|
1
2
| <tag>(..) 等价于 <tag>.find_all(..)
soup(..) 等价于 soup.find_all(..)
|
实例:”中国大学排名定向爬虫“#
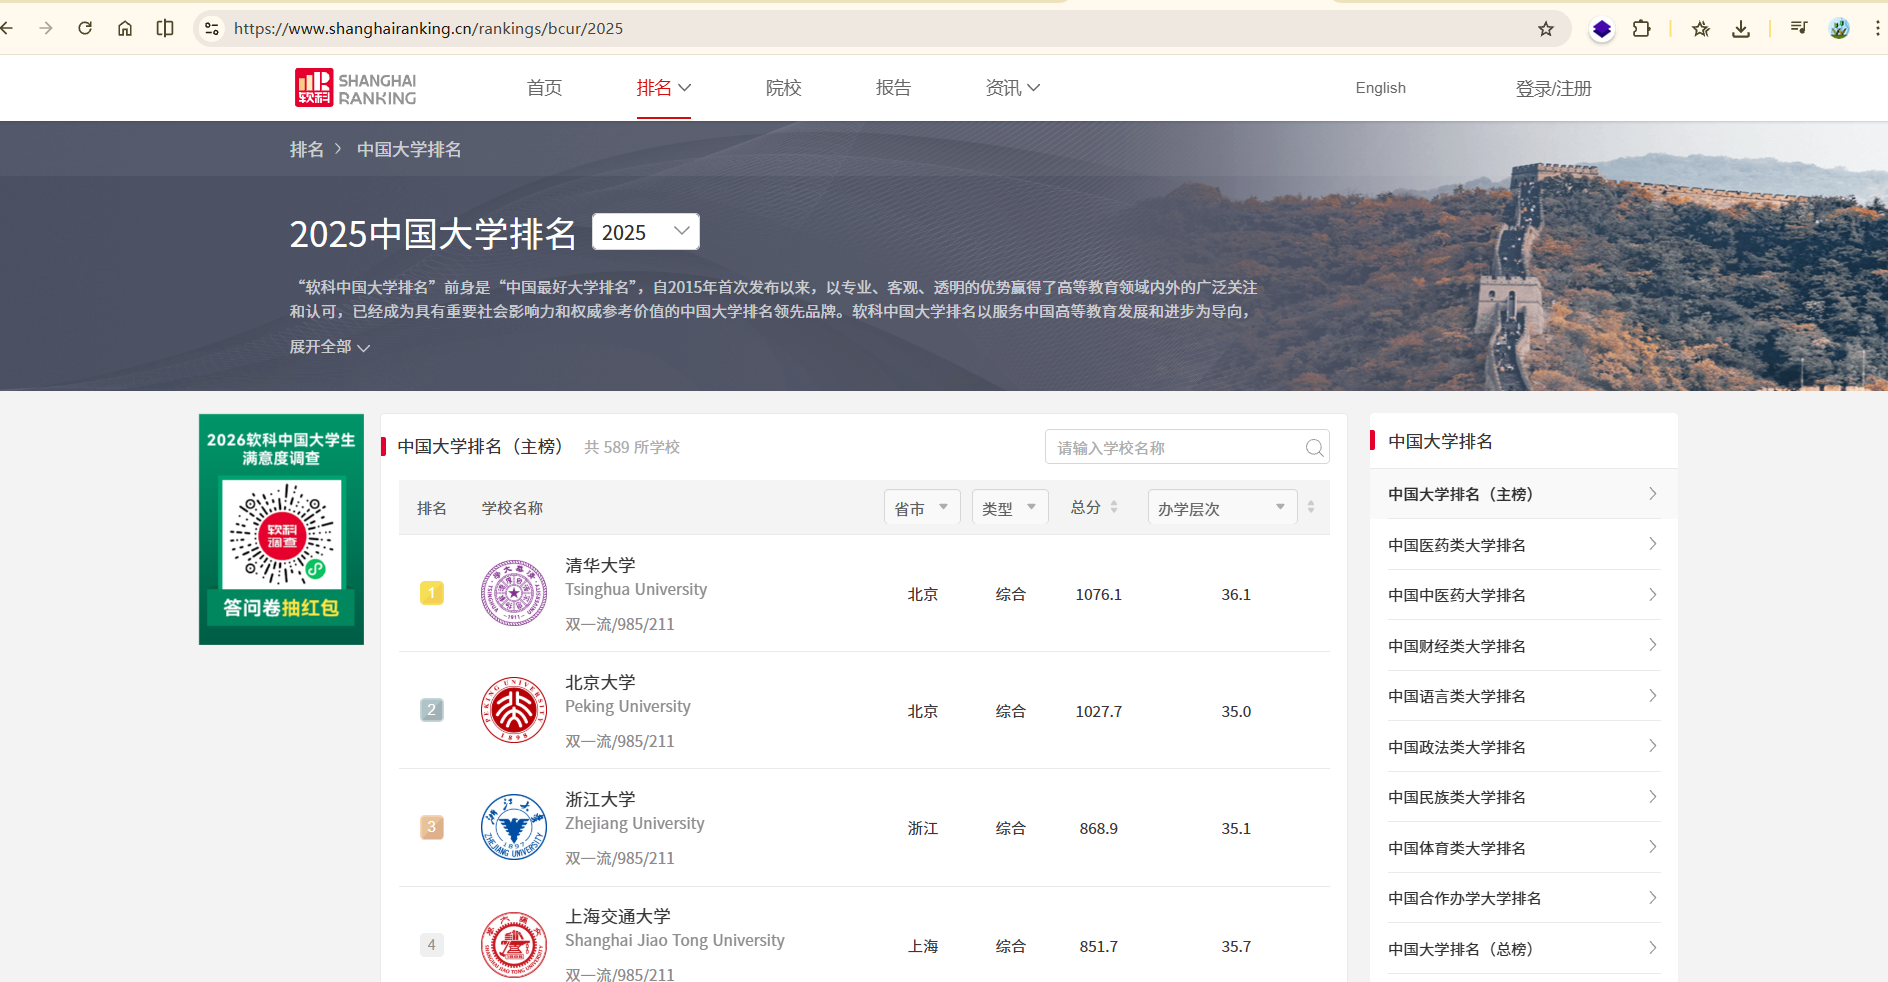
功能描述#
输入:大学排名URL链接
输出:大学排名信息的屏幕输出(排名,大学名称,总分)
技术路线:requests‐bs4
定向爬虫:仅对输入URL进行爬取,不扩展爬取
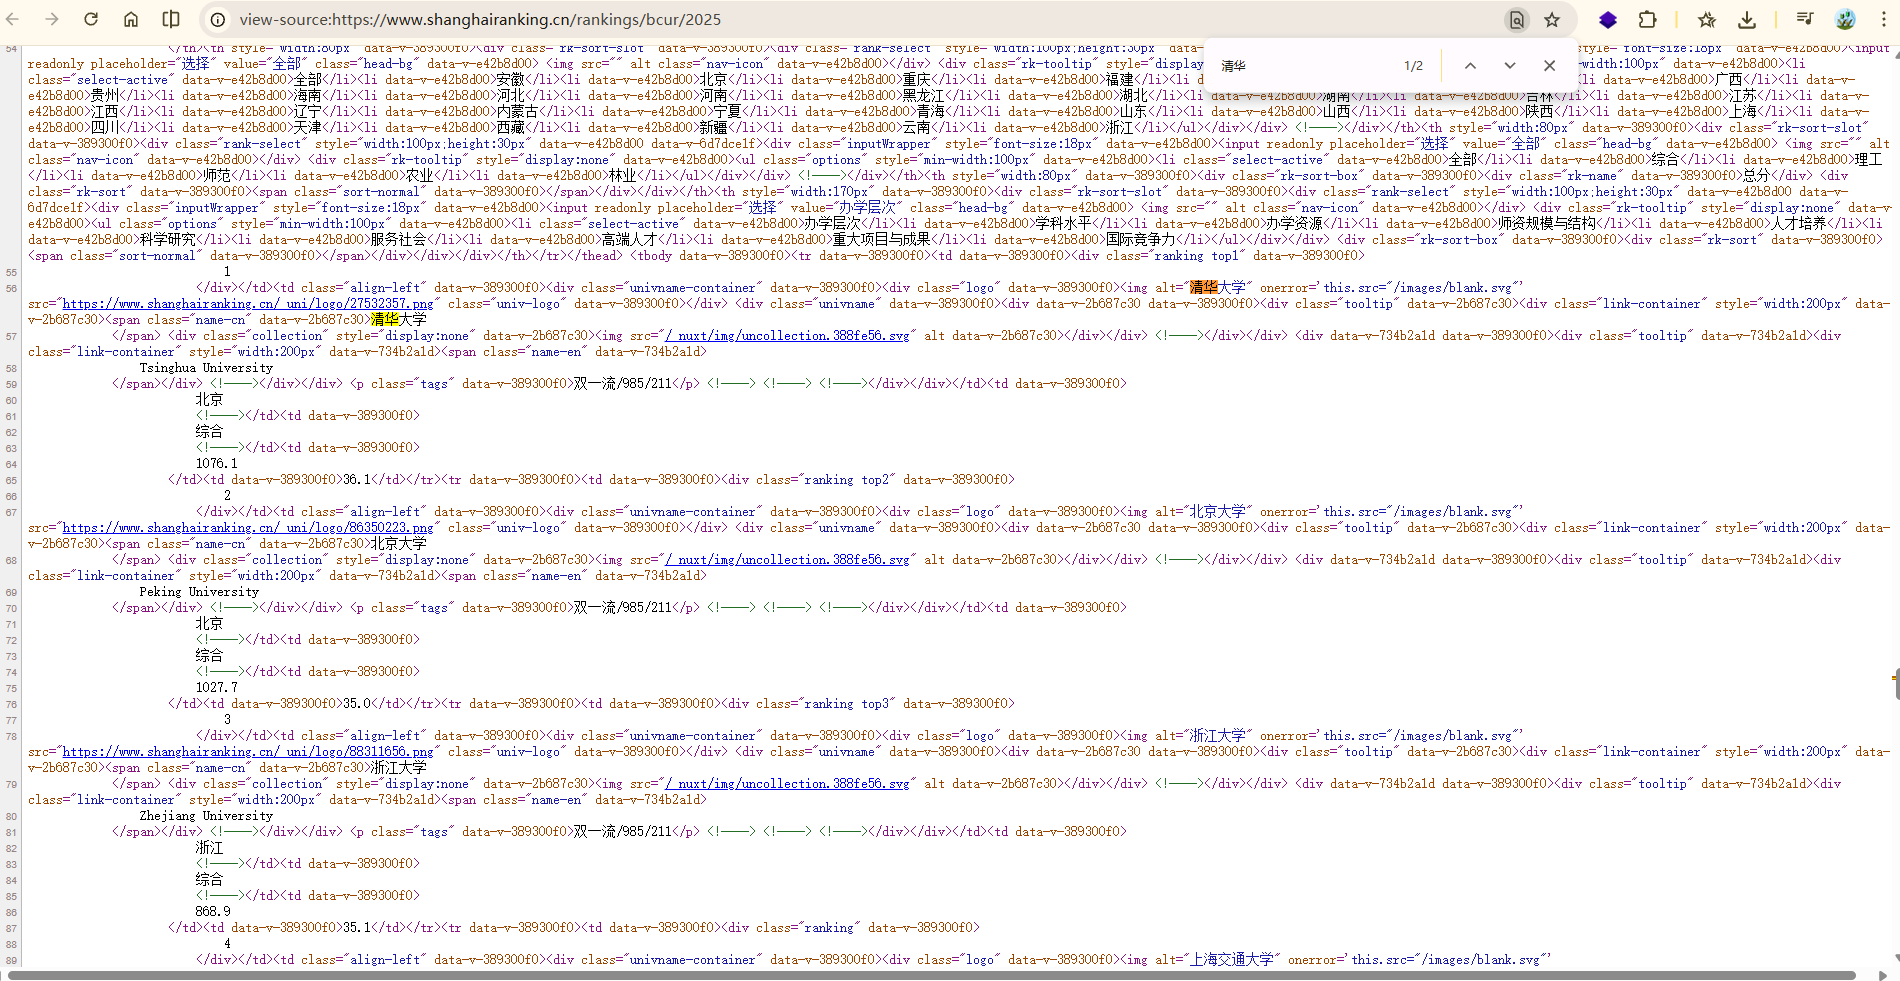
定向爬虫可行性#
程序的结构设计#
步骤1:从网络上获取大学排名网页内容 getHTMLText()
步骤2:提取网页内容中信息到合适的数据结构 fillUnivList()
步骤3:利用数据结构展示并输出结果 printUnivList()
实例编写#
1
2
| import requests
from bs4 import BeautifulSoup
|
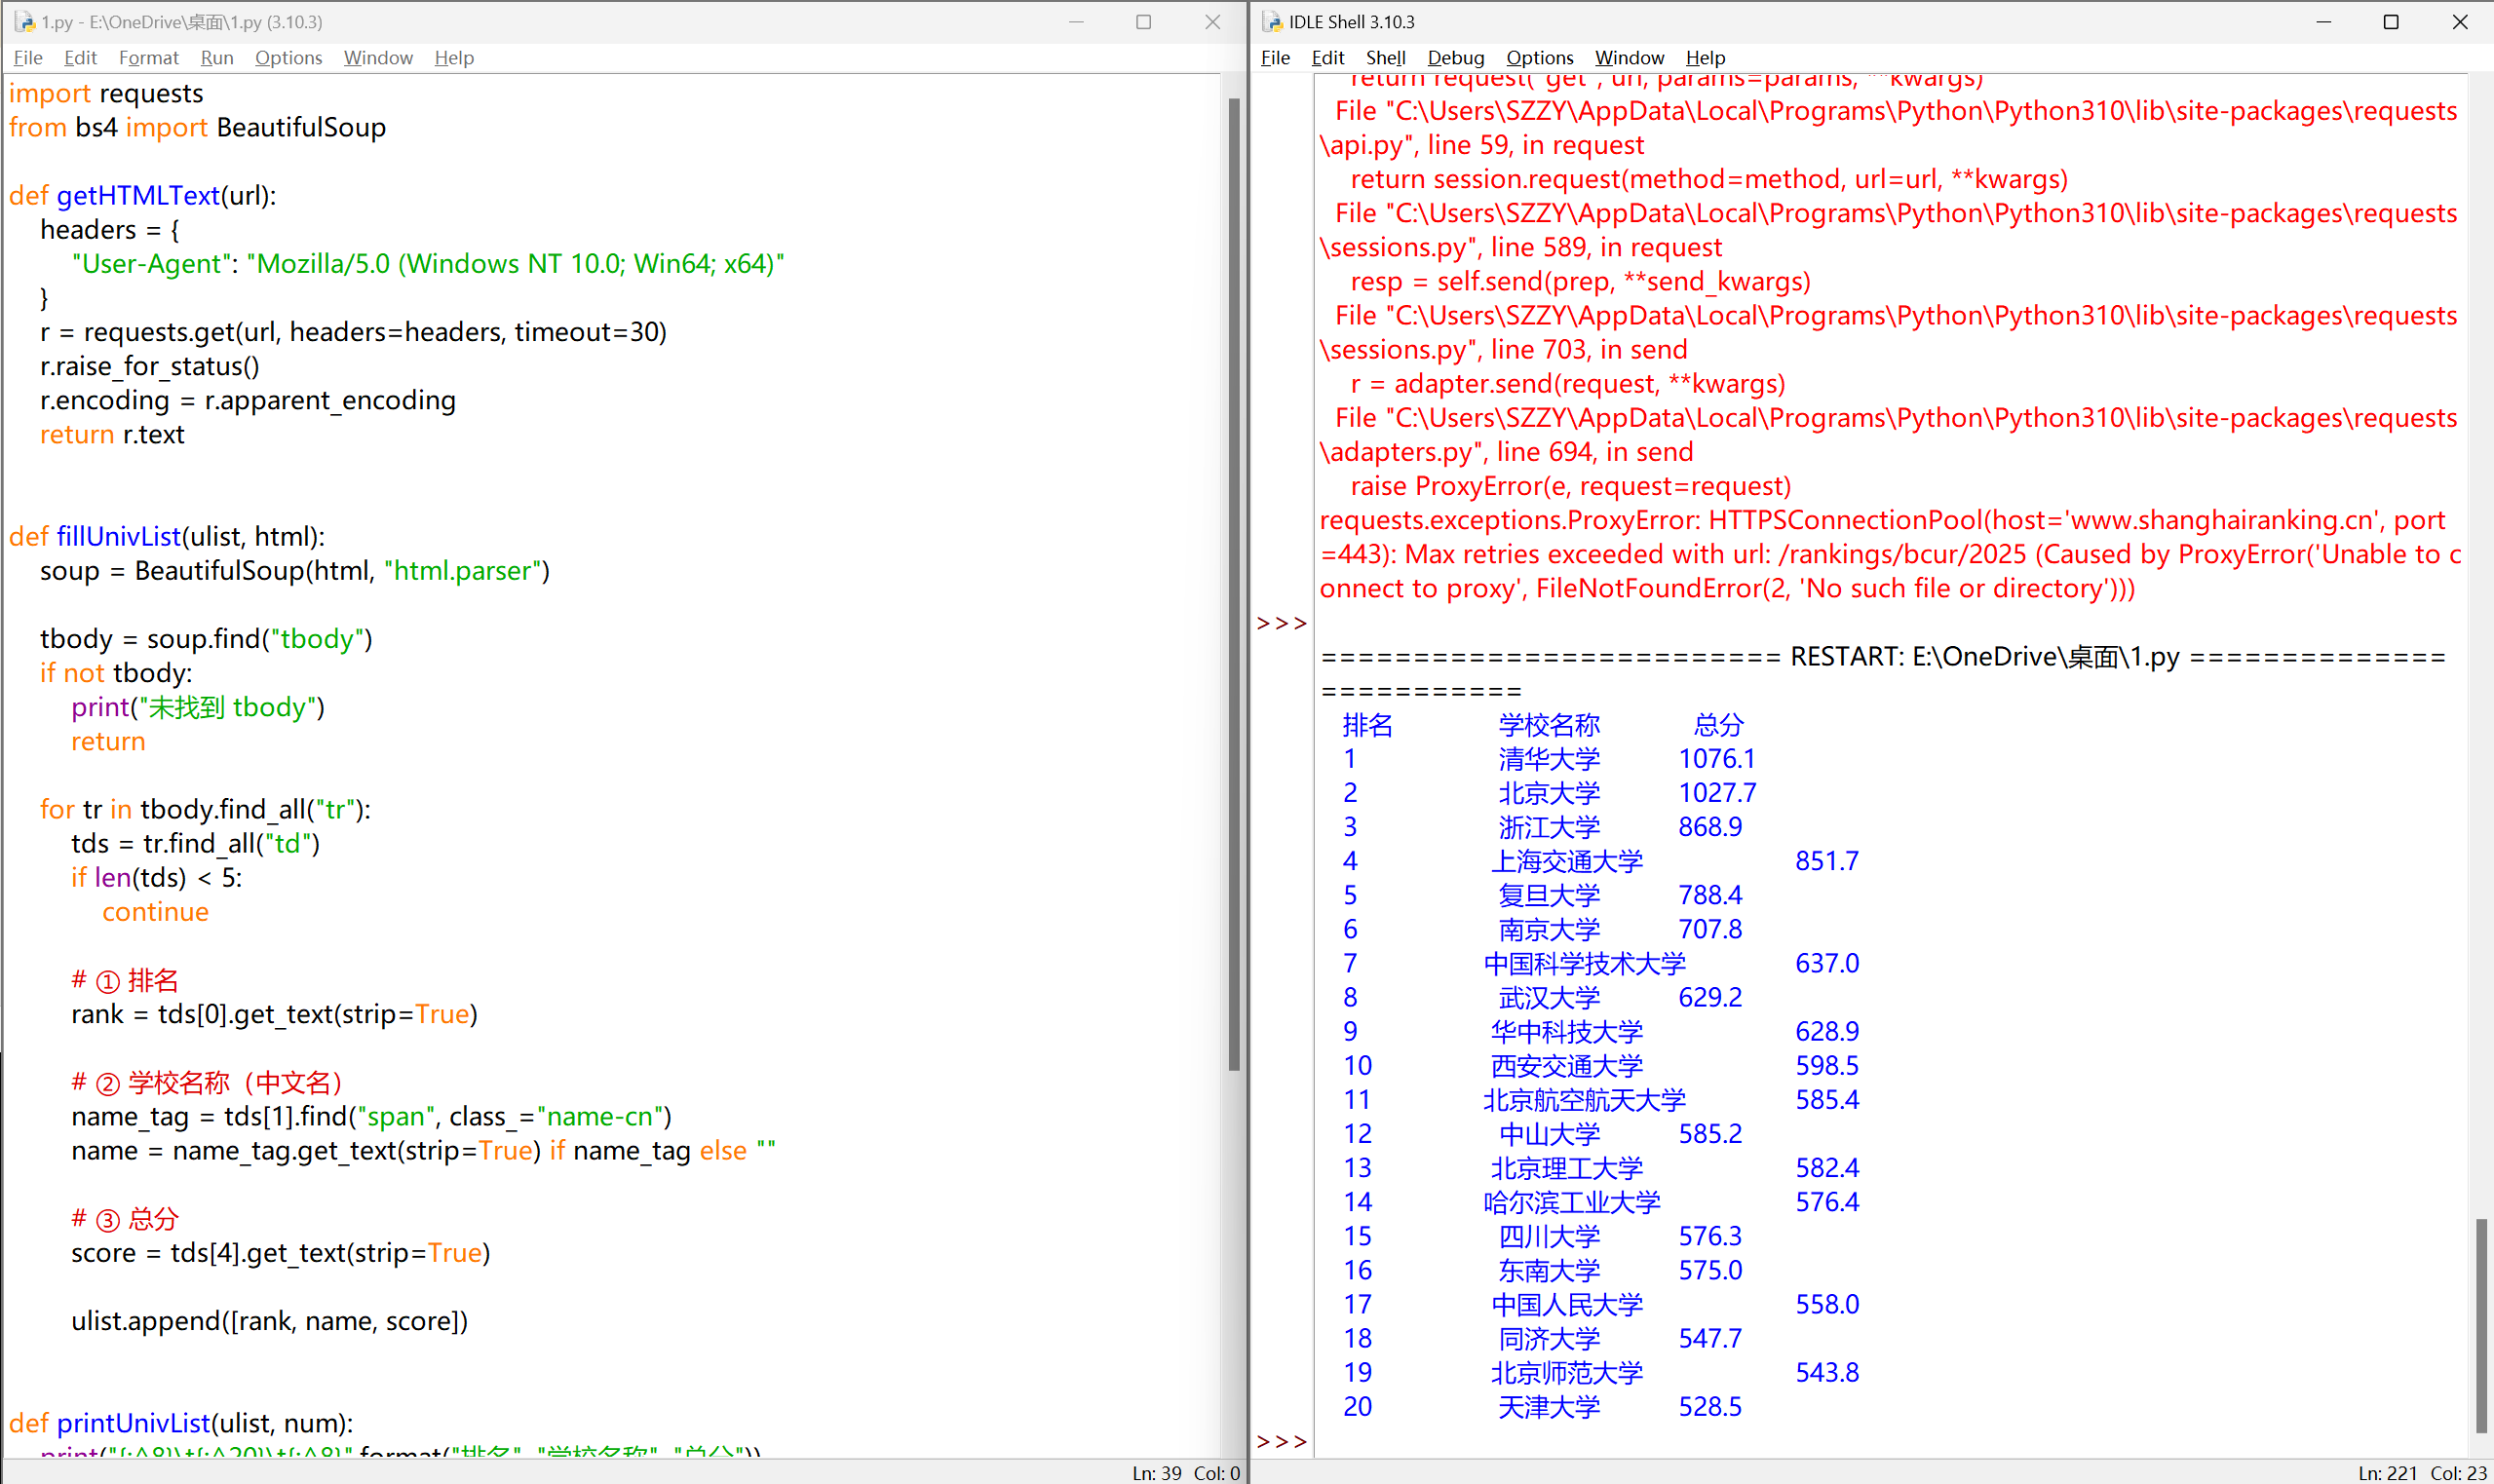
在课程中,排名网用的是 HTML 表格,而现在的排名网用的是 JSON 格式的,
所以我重新写一个代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
| #CrawUnivRankingA.py
import requests
from bs4 import BeautifulSoup
import bs4
def getHTMLText(url):
try:
r = requests.get(url, timeout=30)
r.raise_for_status()
r.encoding = r.apparent_encoding
return r.text
except:
return ""
def fillUnivList(ulist, html):
soup = BeautifulSoup(html, "html.parser")
for tr in soup.find('tbody').children:
if isinstance(tr, bs4.element.Tag):
tds = tr('td')
ulist.append([tds[0].string, tds[1].string, tds[3].string])
def printUnivList(ulist, num):
print("{:^10}\t{:^6}\t{:^10}".format("排名","学校名称","总分"))
for i in range(num):
u=ulist[i]
print("{:^10}\t{:^6}\t{:^10}".format(u[0],u[1],u[2]))
def main():
uinfo = []
url = 'http://www.zuihaodaxue.cn/zuihaodaxuepaiming2016.html'
html = getHTMLText(url)
fillUnivList(uinfo, html)
printUnivList(uinfo, 20) # 20 univs
main()
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
| #CrawUnivRankingB.py
import requests
from bs4 import BeautifulSoup
import bs4
def getHTMLText(url):
try:
r = requests.get(url, timeout=30)
r.raise_for_status()
r.encoding = r.apparent_encoding
return r.text
except:
return ""
def fillUnivList(ulist, html):
soup = BeautifulSoup(html, "html.parser")
for tr in soup.find('tbody').children:
if isinstance(tr, bs4.element.Tag):
tds = tr('td')
ulist.append([tds[0].string, tds[1].string, tds[3].string])
def printUnivList(ulist, num):
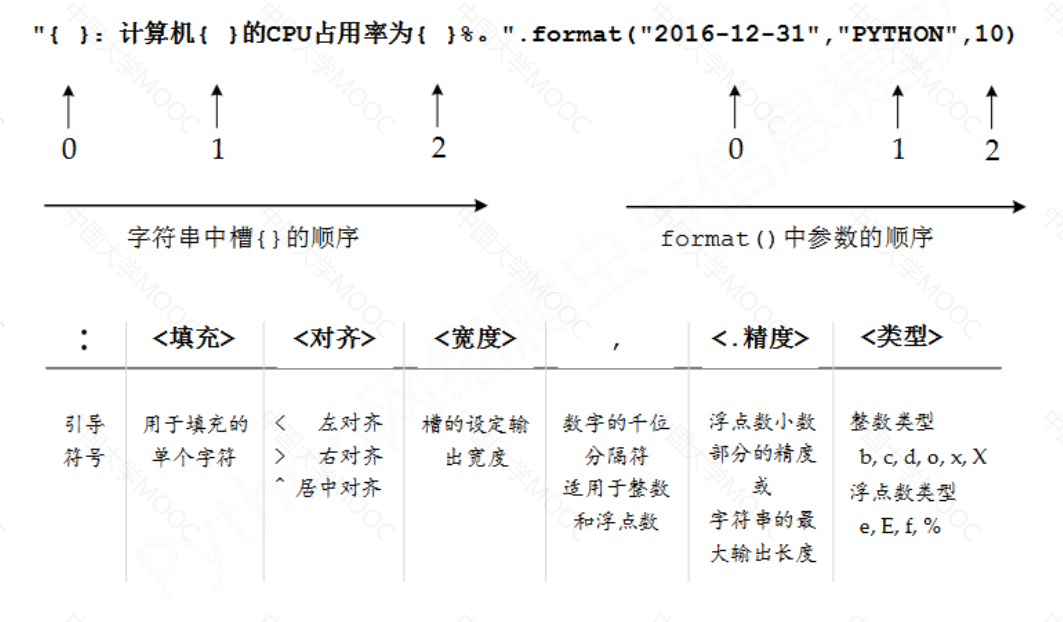
tplt = "{0:^10}\t{1:{3}^10}\t{2:^10}"
print(tplt.format("排名","学校名称","总分",chr(12288)))
for i in range(num):
u=ulist[i]
print(tplt.format(u[0],u[1],u[2],chr(12288)))
def main():
uinfo = []
url = 'http://www.zuihaodaxue.cn/zuihaodaxuepaiming2016.html'
html = getHTMLText(url)
fillUnivList(uinfo, html)
printUnivList(uinfo, 20) # 20 univs
main()
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
| import requests
from bs4 import BeautifulSoup
def getHTMLText(url):
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"
}
r = requests.get(url, headers=headers, timeout=30)
r.raise_for_status()
r.encoding = r.apparent_encoding
return r.text
def fillUnivList(ulist, html):
soup = BeautifulSoup(html, "html.parser")
tbody = soup.find("tbody")
if not tbody:
print("未找到 tbody")
return
for tr in tbody.find_all("tr"):
tds = tr.find_all("td")
if len(tds) < 5:
continue
# ① 排名
rank = tds[0].get_text(strip=True)
# ② 学校名称(中文名)
name_tag = tds[1].find("span", class_="name-cn")
name = name_tag.get_text(strip=True) if name_tag else ""
# ③ 总分
score = tds[4].get_text(strip=True)
ulist.append([rank, name, score])
def printUnivList(ulist, num):
print("{:^8}\t{:^20}\t{:^8}".format("排名", "学校名称", "总分"))
for u in ulist[:num]:
print("{:^8}\t{:^20}\t{:^8}".format(u[0], u[1], u[2]))
def main():
uinfo = []
url = "https://www.shanghairanking.cn/rankings/bcur/2025"
html = getHTMLText(url)
fillUnivList(uinfo, html)
printUnivList(uinfo, 20)
if __name__ == "__main__":
main()
|