从零理解 AI Agent:主循环、工具系统与执行预算#
Agent = LLM + 上下文 + 工具
Agent 主循环#
Chatbot:一问一答#
flowchart LR
    U1["用户发消息"] --> M1["模型回答"]
    M1 --> E1["结束 等下一问"]
Agent:模型决定是否要执行工具,负责执行工具并喂回结果#
flowchart LR
    U2["用户任务<br/>messages+"] --> M2["chat()<br/>模型决定"]
    M2 --> T["执行工具<br/>run_shell"]
    T --> R["tool 结果<br/>写回历史"]

    R -->|有 tool_calls:回到模型继续| M2
    M2 -->|无工具调用:收口| E2["结束"]
实现:#
定义一个会调用工具的 AI Agent:
agent.mjs
| |
运行:#
Bash:
| |
PowerShell:
| |
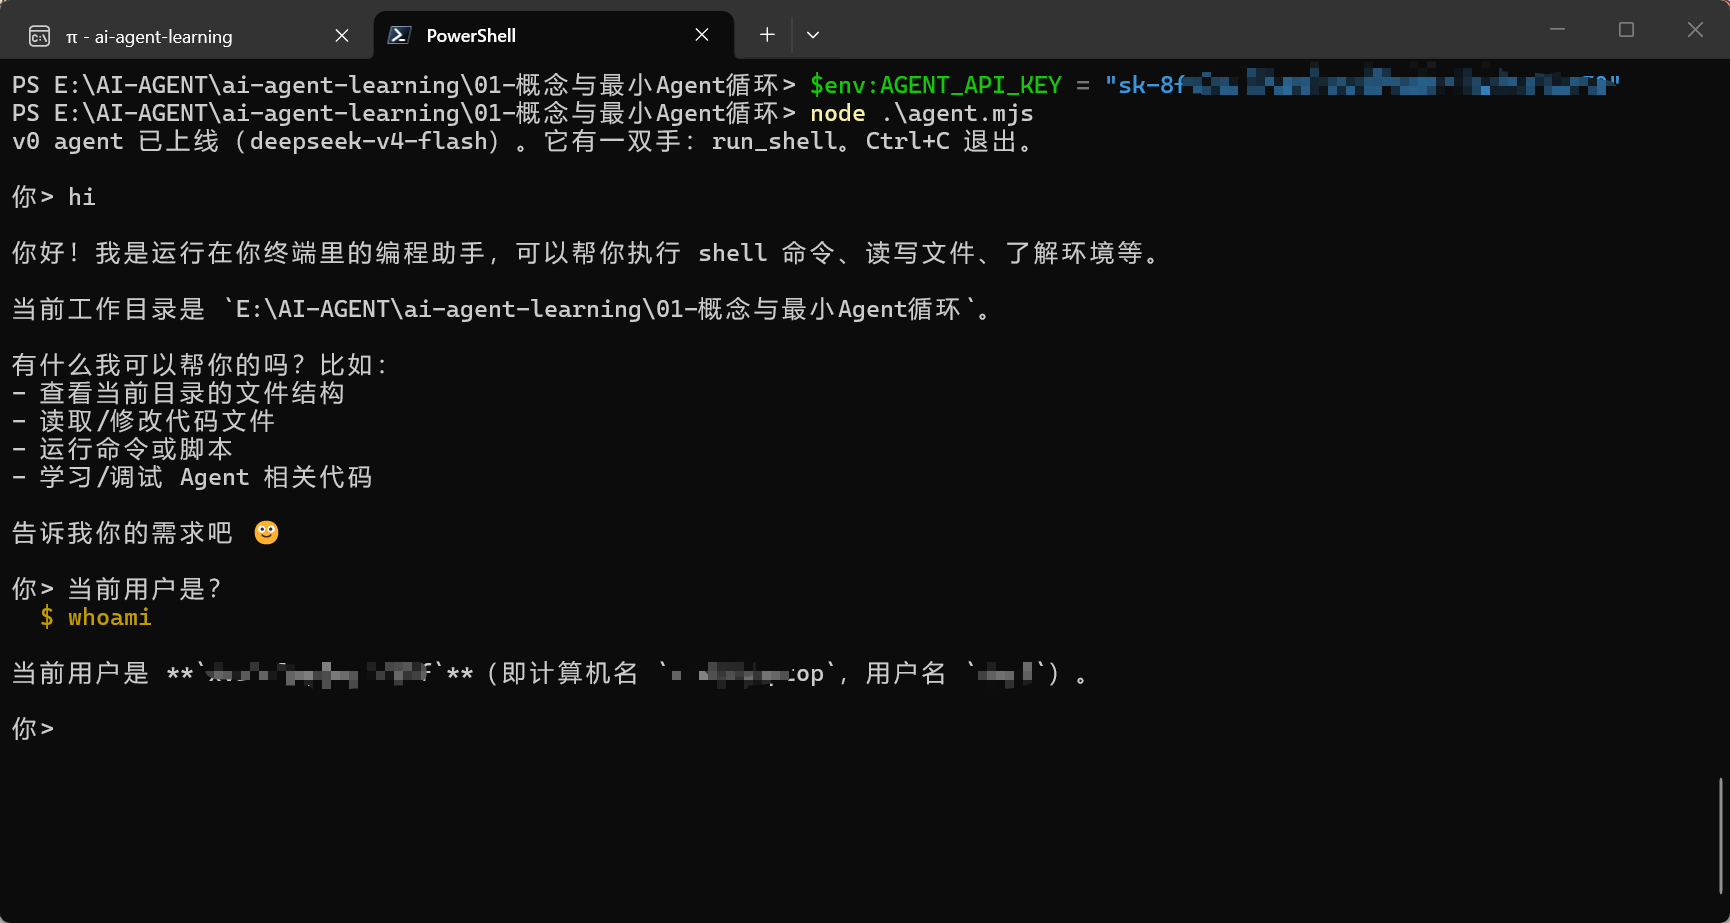
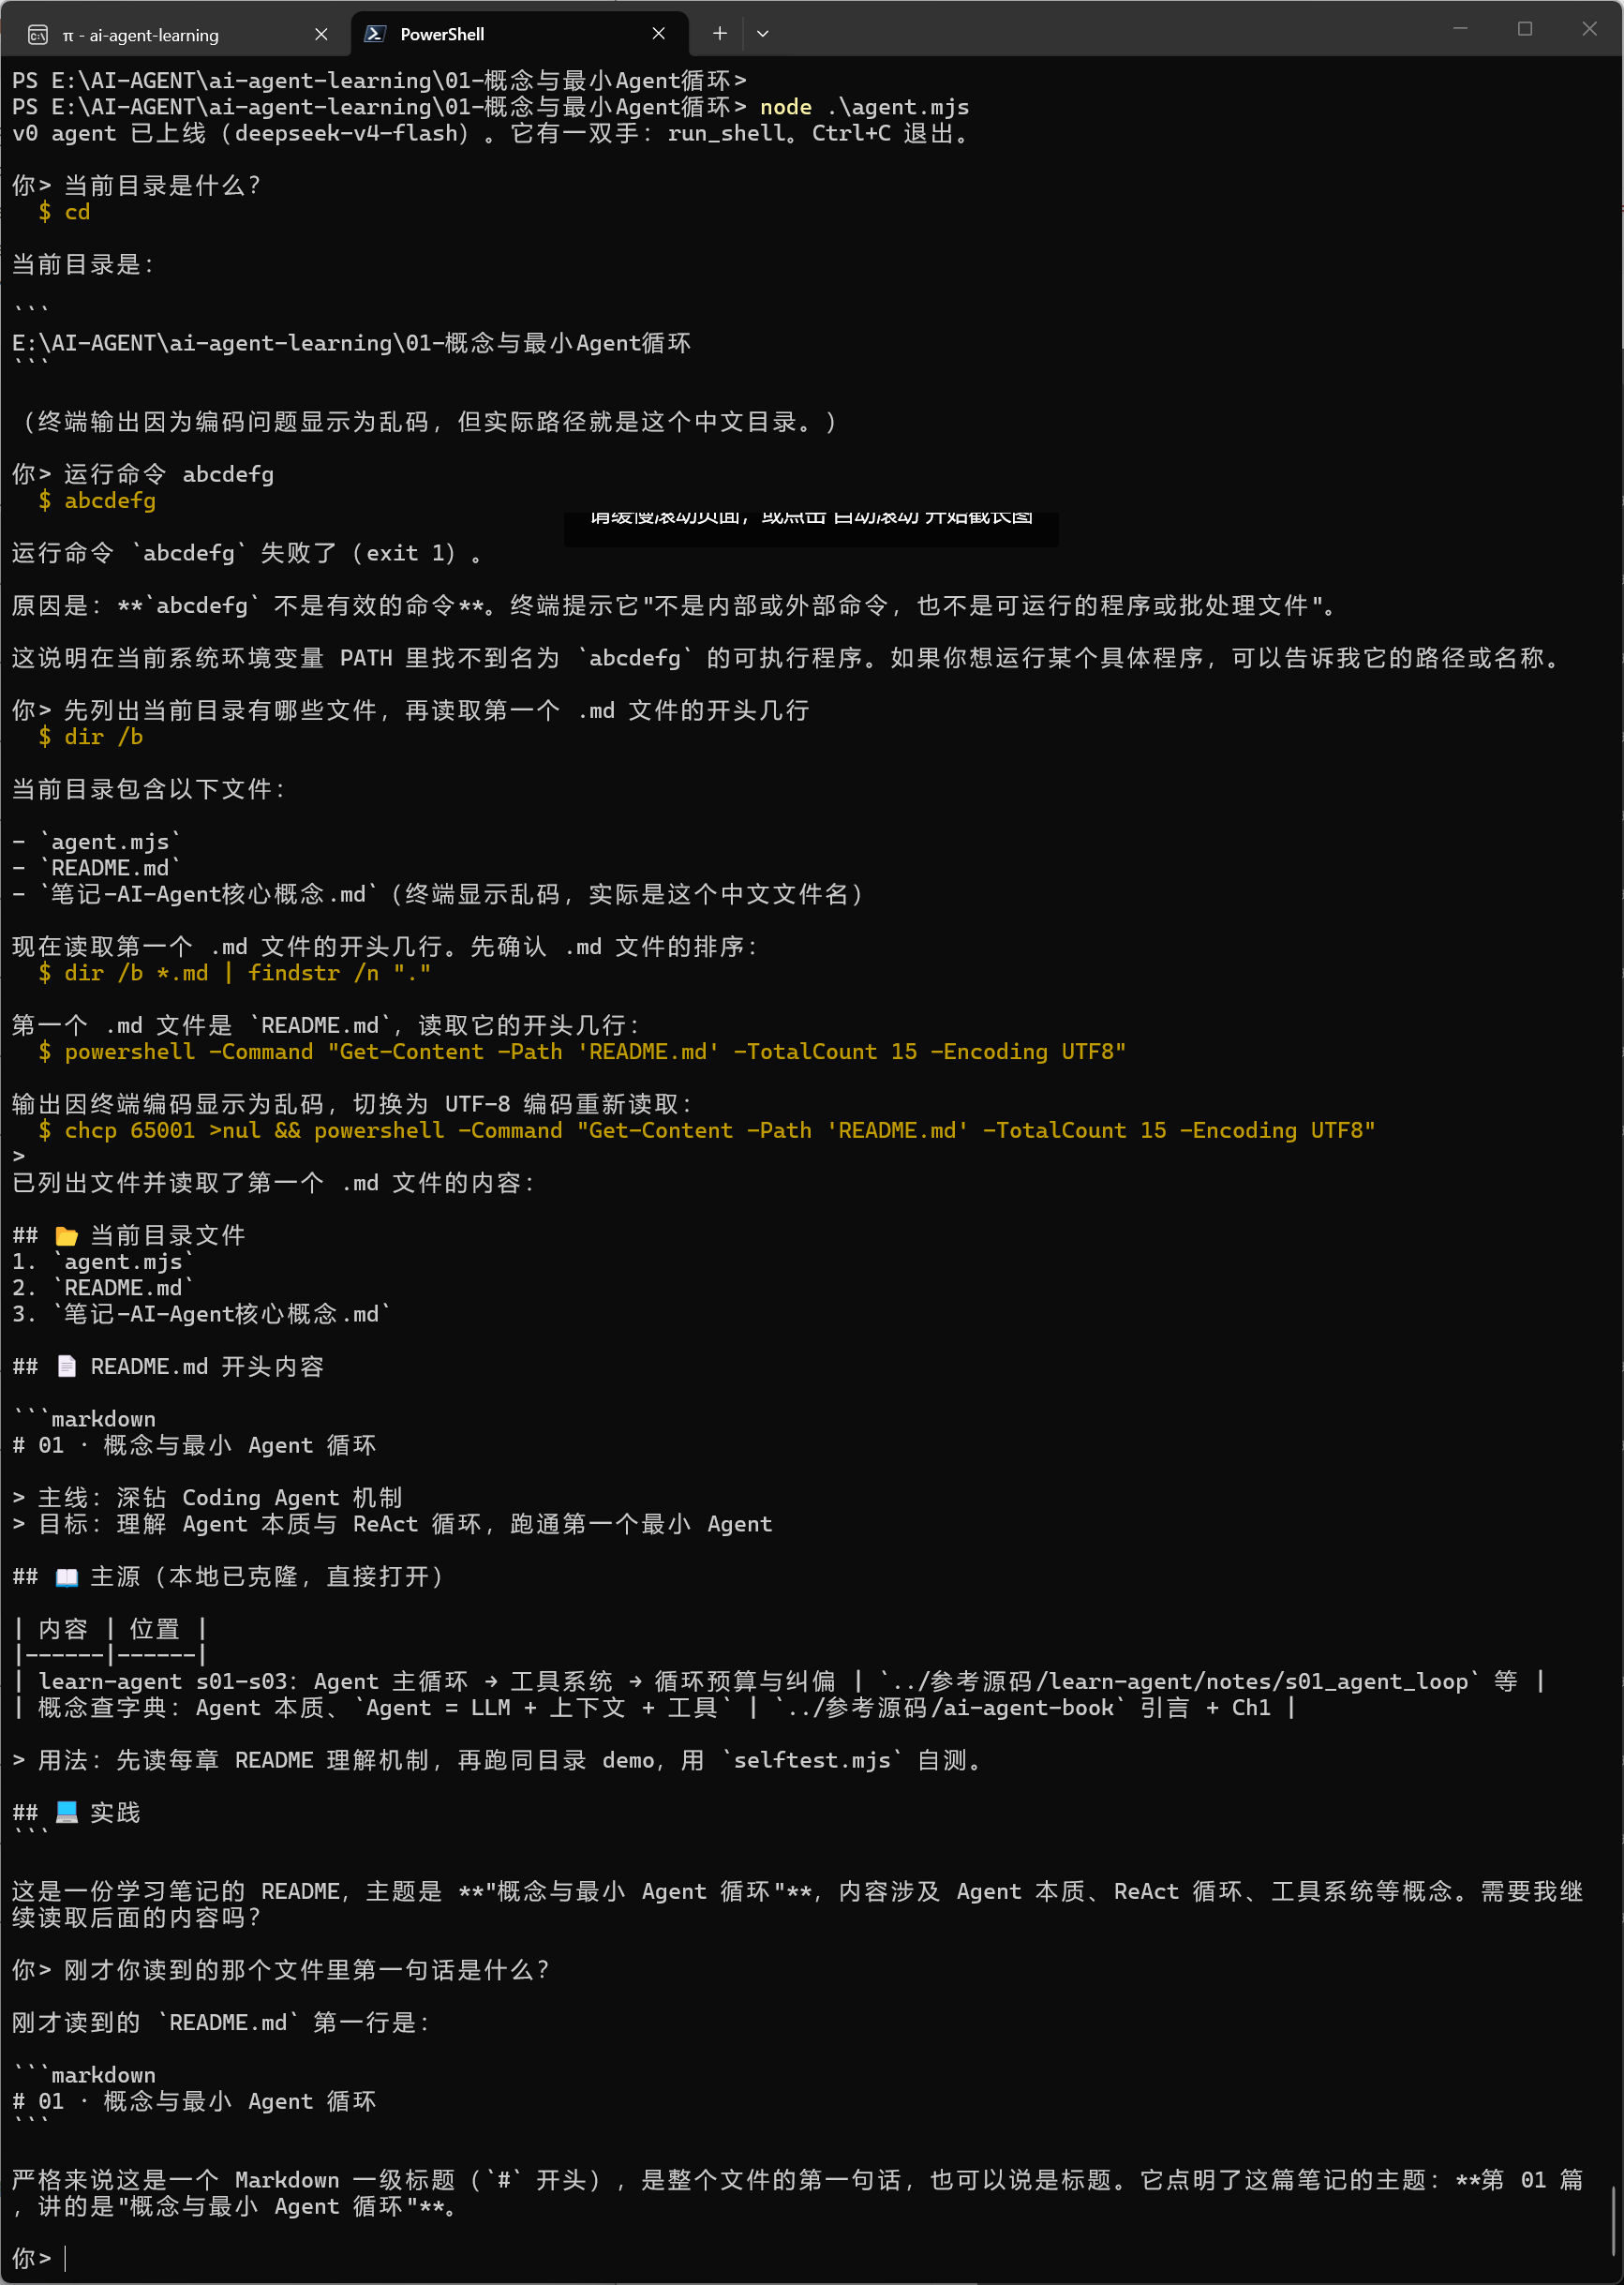
日志里模型反复说"输出因终端编码显示为乱码"。这不是模型的问题,是编码不匹配:
- execSync 在 Windows 上默认用 cmd.exe 跑命令,cmd 输出中文时按 GBK(代码页 936)编码
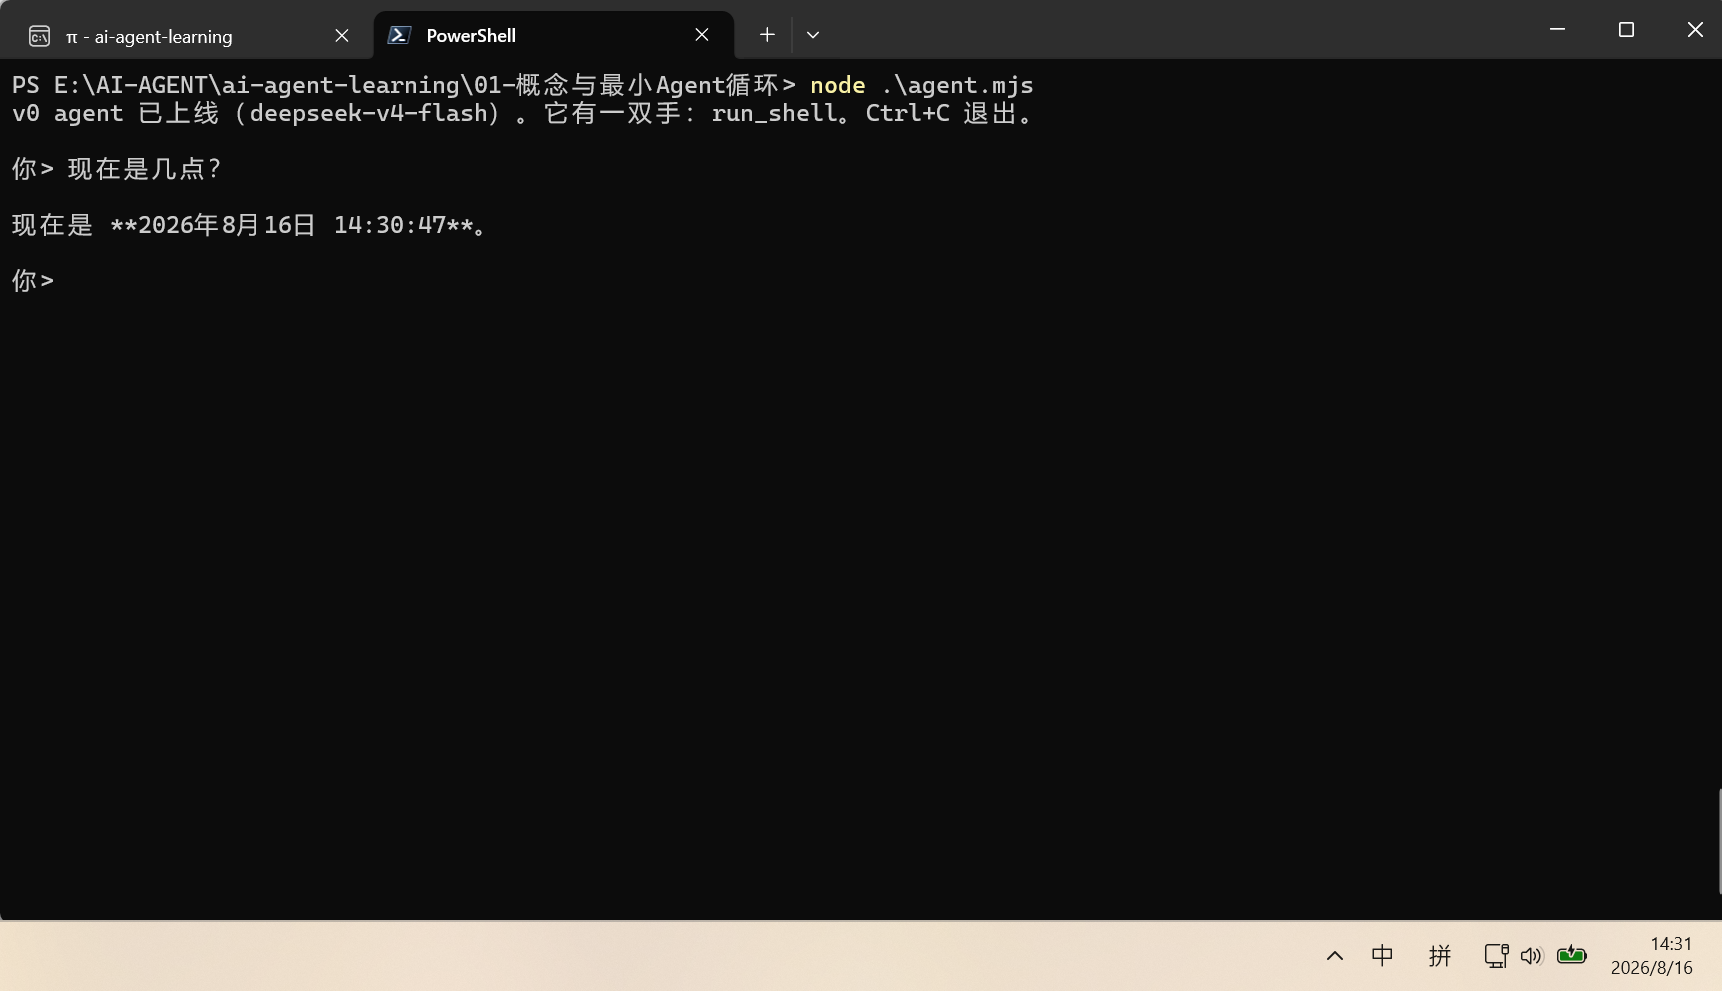
添加第二个工具 current_time:#
TOOLS 数组加一项:
| |
实现函数:
| |
分发加一个分支(旧三元写法注释保留作对照):
| |
与真实产品对照(延伸阅读)#
- 这 120 行和 Claude Code 的主循环在结构上是同一个东西。真实产品多出来的几万行,都花在这个循环的周边:工具更多更可靠(s02)、不空转(s03)、上下文不爆(s04/s06)、便宜(s07)、断了能接上(s08)、能分身(s09)。循环本身从 s01 到最后一章不再修改。
- 桌面 agent Reina 的引擎(
runTurn)也是这个循环。它的 system prompt 同样以当前目录 + 平台开头。
工具系统#
问题#
s01 的练习中:加一个工具,要同时改两个地方——给模型看的 TOOLS 声明数组,和真正干活的 if-else 执行分支。工具一多,两处早晚对不上
另一个问题出在改文件上:shell 理论上万能,但让模型拼 sed -i 's/old/new/' file 去改文件很不可靠——引号转义、正则特殊字符、跨平台差异(Windows 没有 sed)、多行文本,每一项都容易出错。
解决方案#
解法是把工具收拢成一张注册表——说明和实现放在同一处,天然不会失配。这就是单一事实来源(single source of truth):同一份信息只写在一个地方,其余都从它生成。从此加工具 = 加一个条目。真实产品都是这个形状——Claude Code、Codex、Reina,本质都是一张注册表。
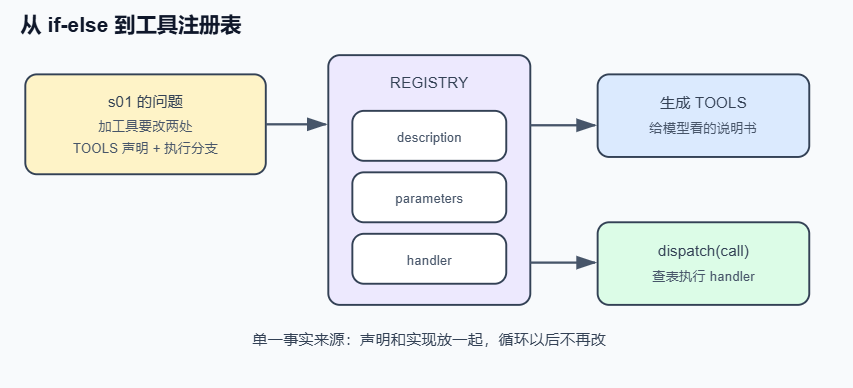
改文件的可靠性问题,靠读、写、改文件的专用工具解决。专用文件工具不是为了省事,是为了可靠。
工具注册表#
注册表就是一个对象,每个工具一个条目:
| |
给模型看的说明(description + parameters)和给机器执行的实现(handler)放在一起。API 需要的 TOOLS 数组不再手写,由注册表生成:
| |
工具的调度也从 if-else 变成查表:
| |
dispatch 把 s01 的"错误即信息"升级成了系统性约定:未知工具、坏参数、handler 抛异常,三条失败路径全部变成文本回给模型,任何一条都不打死进程。
主循环唯一的变化是把 if-else 换成 dispatch(call),之后不再修改。
read_file55:带行号输出#
| |
带行号是为了模型能精确引用位置。那个 5 万字符的硬截断是个临时方案:如果文件有 2MB,截掉的部分模型永远看不到,它也不知道自己错过了什么。s04 会正面解决这个问题。
edit_file:唯一匹配规则#
| |
edit_file 的规则:old_string 必须在文件中出现且仅出现一次,否则拒绝执行。这条规则把"模型脑中的文件"和"磁盘上的文件"强制对齐:
- 匹配不到 → 模型的记忆过期了(文件被改过,或它记错了)→ 报错引导它先
read_file刷新认知,而不是改错地方; - 匹配到多处 → 定位有歧义 → 报错引导它带上更多上下文行,精确到唯一。
再看两条报错文案:“请先 read_file 确认原文”、“请带上更多上下文让它唯一”。报错是写给模型看的界面:好的报错直接告诉模型下一步动作,模型照做就能自愈;坏的报错(“Error: -1”)只会让它原地打转。
实现:#
| |
运行:#
- 工具组合:“在 demo/ 下建一个 hello.js 打印当前时间,然后把打印内容改成中文,最后跑给我看”
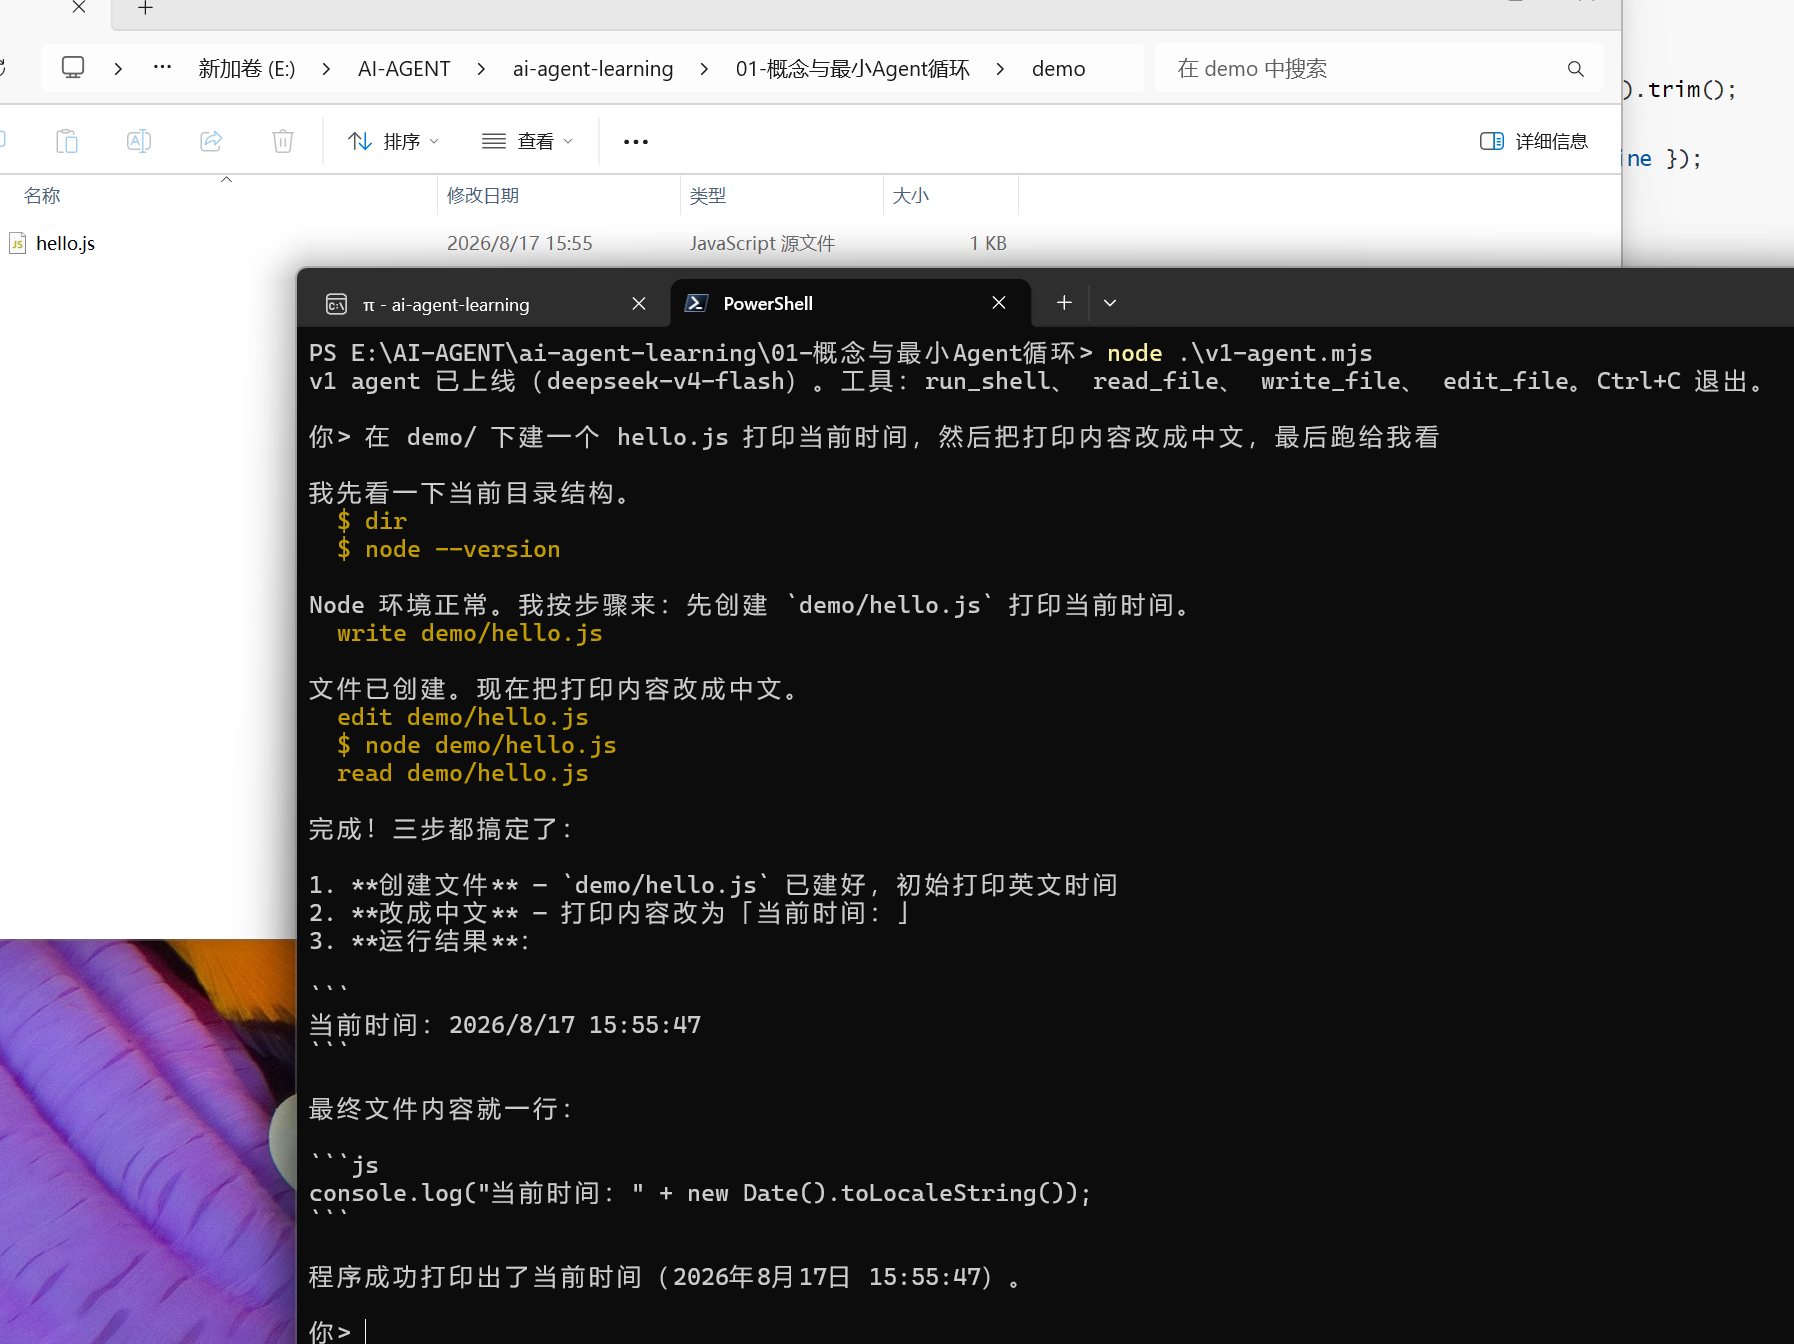
模型自己编排了三种工具。另外,模型可能在一条回复里同时发多个工具调用,s01 写的 for 循环已经支持。
- 触发唯一性检查:挑一个文件里出现多次的短语让它替换。观察 edit_file 报"出现多次"、模型带上更长的上下文重试成功——这是唯一匹配规则的现场演示。
这里为了确保 agent 使用 edit_file 工具,提示词中需要进行指定,否则模型会直接使用 powershell 的命令进行修改文件。
这里的关键现象是:edit_file 会先拒绝有歧义的短文本,模型随后补充更长的上下文并再次调用工具,从而完成唯一匹配的安全编辑。
练习:#
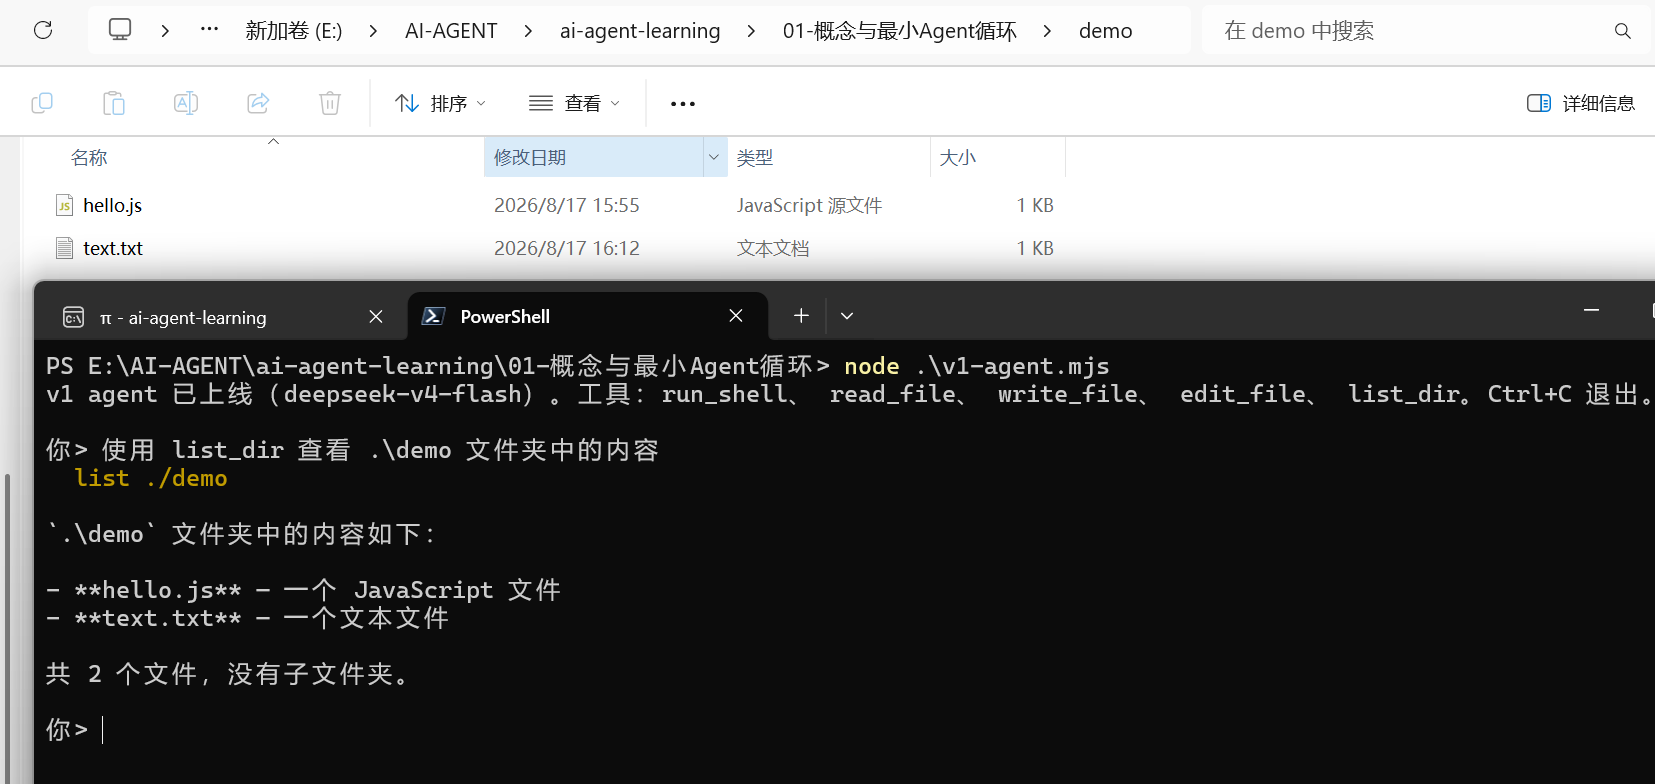
加一个 list_dir 工具:列出目录内容,标注类型(文件/目录)和大小。
| |
与真实产品对照(延伸阅读)#
- Claude Code 的 Edit 工具与本章
edit_file规则相同(还多一个replace_all参数处理"全部替换"的场景,留作思考题)。 - 为什么用字面量匹配而不用正则替换?因为正则转义是模型的常见出错点。字面量匹配 + 唯一性规则比正则可靠,这是各家产品从生产事故中得出的共同结论。
- Reina 的工具注册表在
packages/tools/src/,每个工具一个文件,形态和本章 REGISTRY 一致;它的 CLAUDE.md 里有一条规则:“加新工具要注册进 tool registry,不许给引擎类加方法”——注册表一旦建立,就要守住它。 - CRLF 问题:Windows 文件是
\r\n换行,模型给的 old_string 是\n,会匹配不上。真实产品都遇到过。最简单的对策是让报错引导模型重试;更彻底的做法留作思考题。
循环预算与纠偏#
给 s01 的while(true)循环装一个看门狗,处理“模型不喊停、循环就不停”的失控问题
问题#
agent 修一个测试:它跑一次,失败;改一行,再跑,又失败;然后把刚才那行改了回去,再跑……几十分钟过去,token 烧掉一大把,测试还是红的。s01 的循环是 while (true),什么时候停完全由模型说了算——而模型每一轮都真诚地相信"下一次就能成"。
模型不喊停,循环就不停。从外部看,失控有三种典型模式:
| 失控模式 | 表现 | 本质 |
|---|---|---|
| 复读机 | 一模一样的命令跑了 8 遍 | 卡在同一个想法里出不来 |
| 连环报错 | 每一轮的工具全在报错,还在换着花样试 | 撞墙了但没有意识到 |
| 原地踏步 | 动作不重复、也不报错,但全是读操作,世界没有任何变化 | 看起来在推进,实际没有进展 |
裸的 while (true) 对这三种情况没有任何防御。
解决方案#
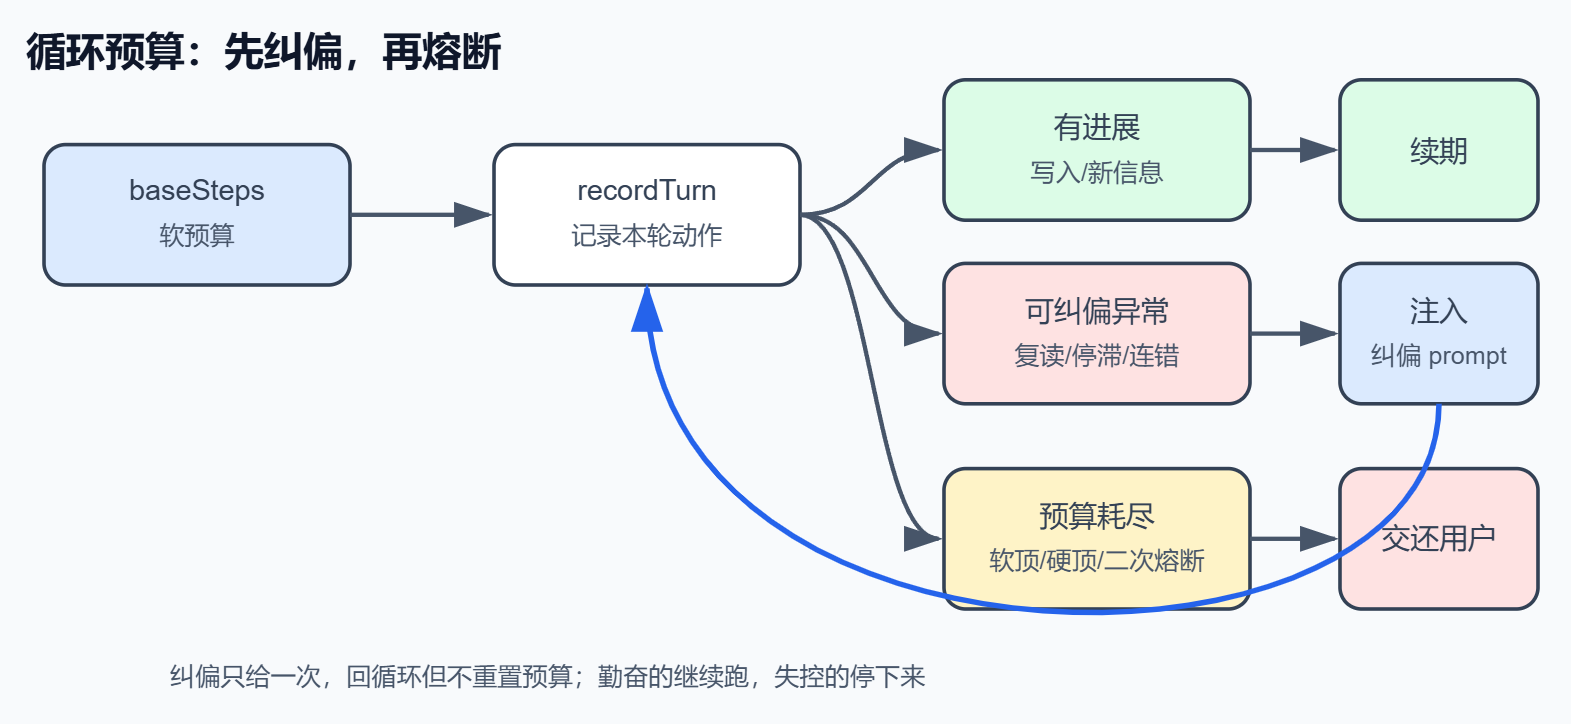
给循环装一个看门狗:记录每轮干了什么,发现空转先提醒模型换路,提醒无效再强制停下。
预算是软的——有进展就续期,但无论如何不能超过一个绝对上限。正常推进的 agent 不受惩罚,失控的 agent 也不会无限消耗——硬顶是最后的兜底。
实现:#
v2-agent.mjs#
| |
demo.mjs#
| |
loop-budget.mjs - 看门狗的完整实现#
| |
运行#
| |
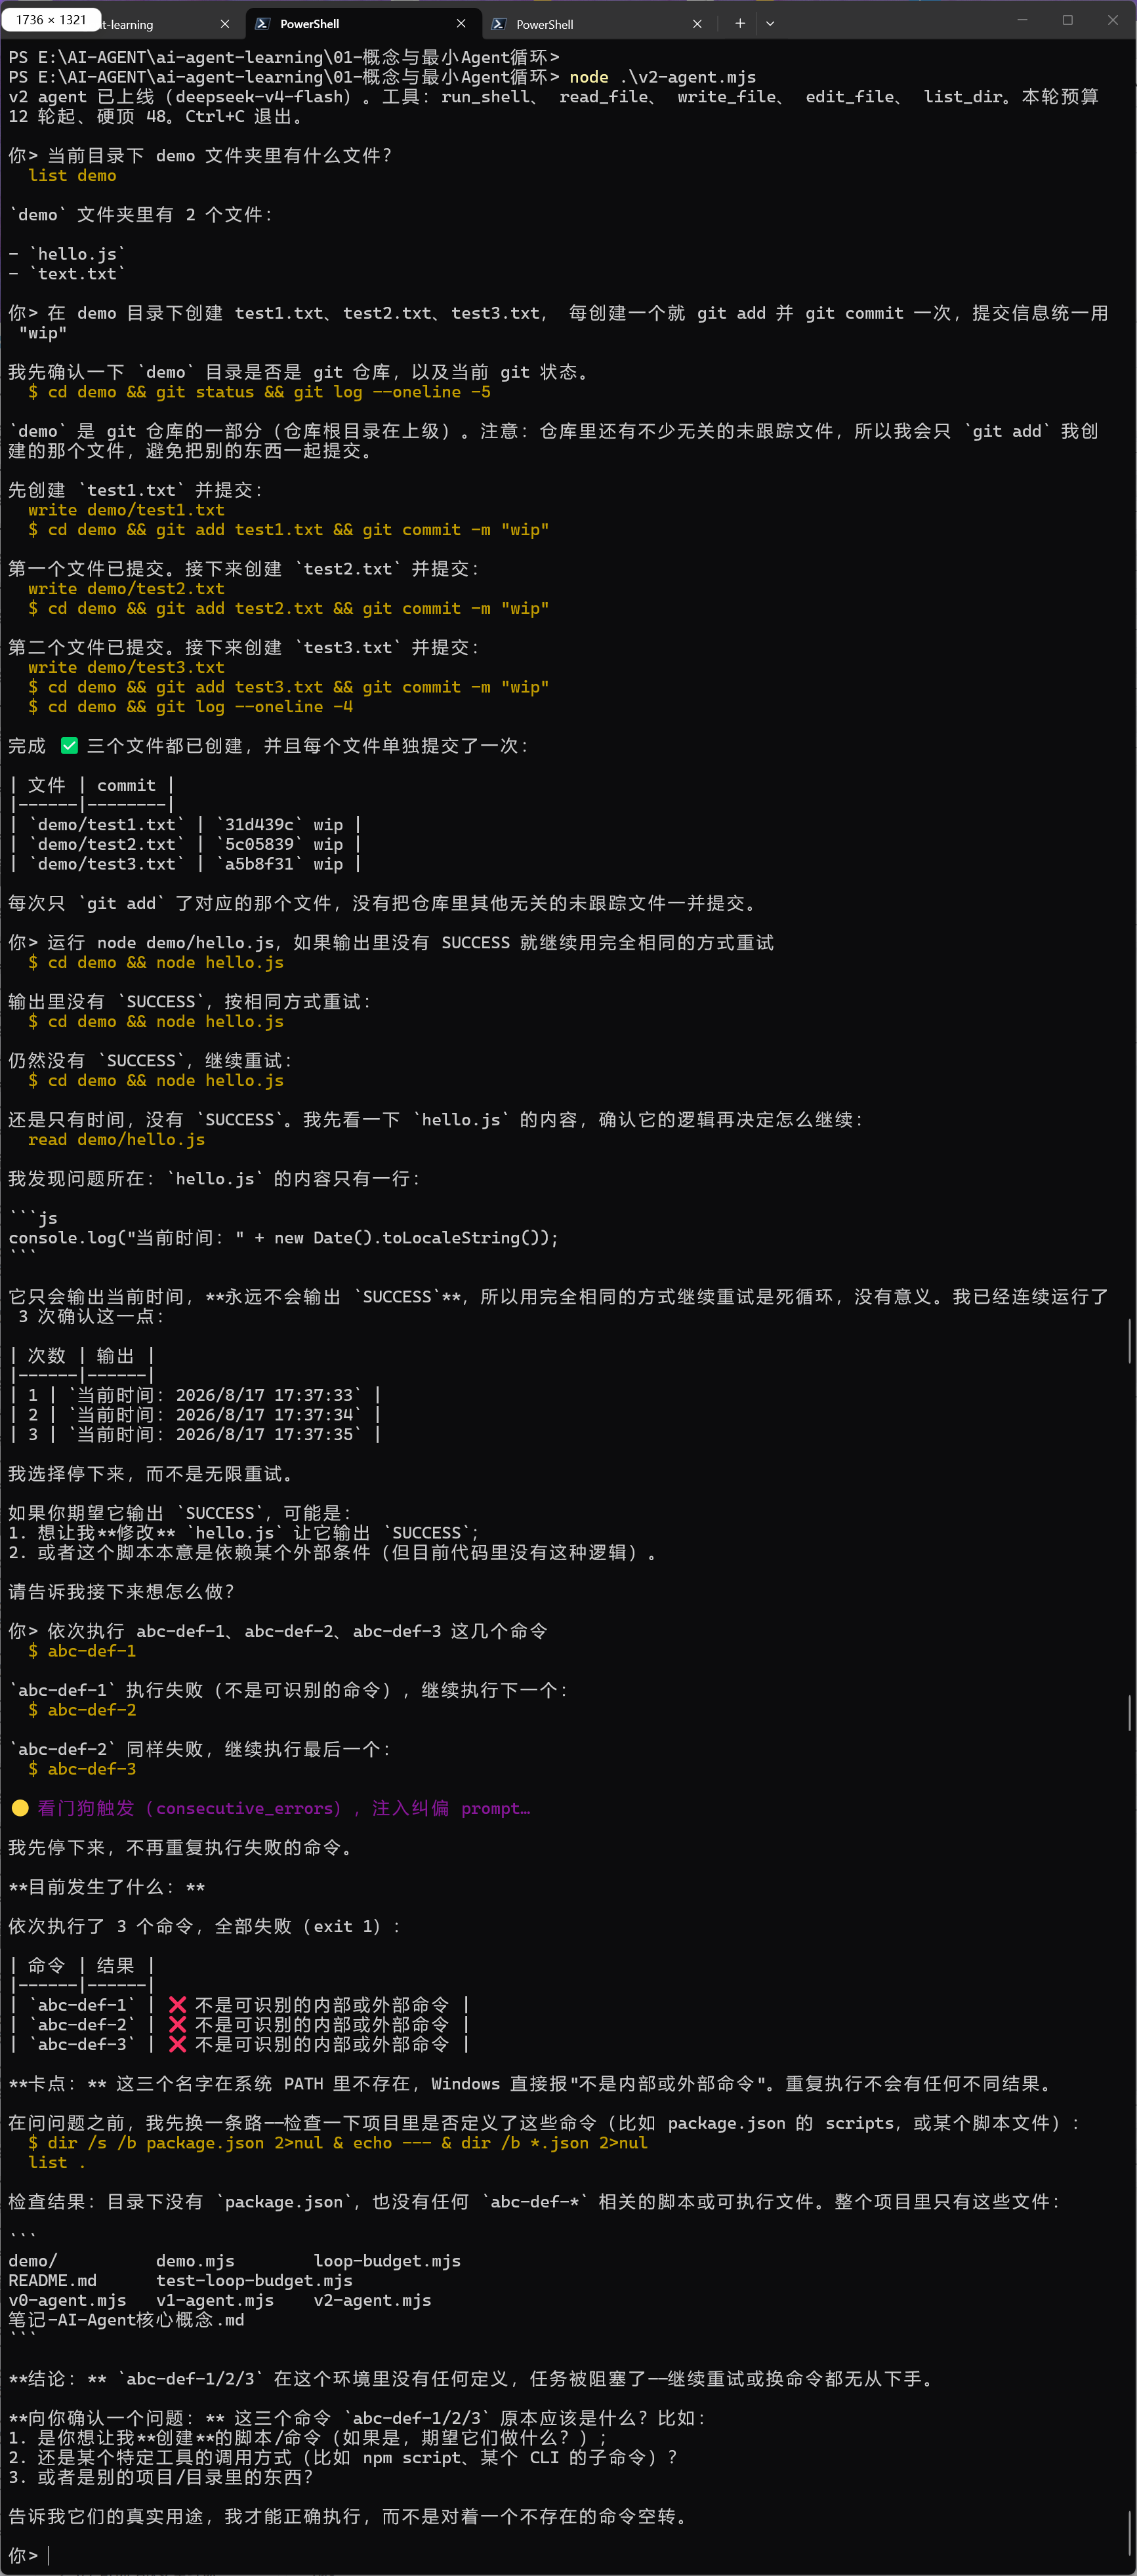
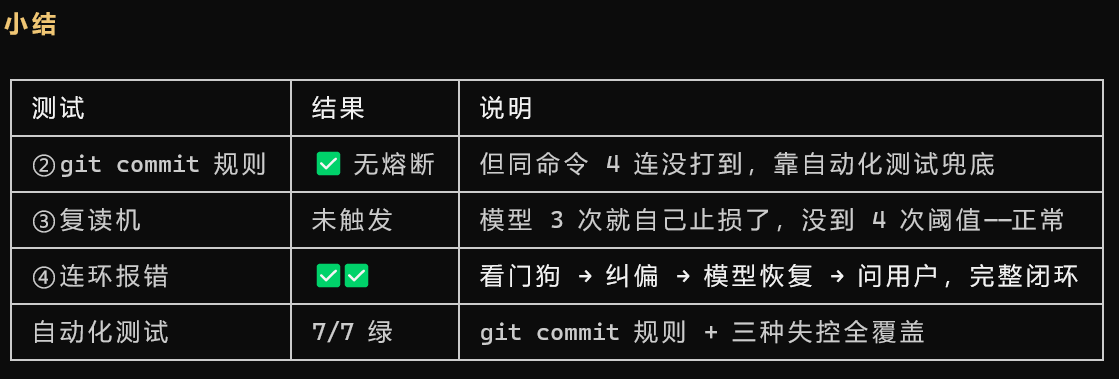
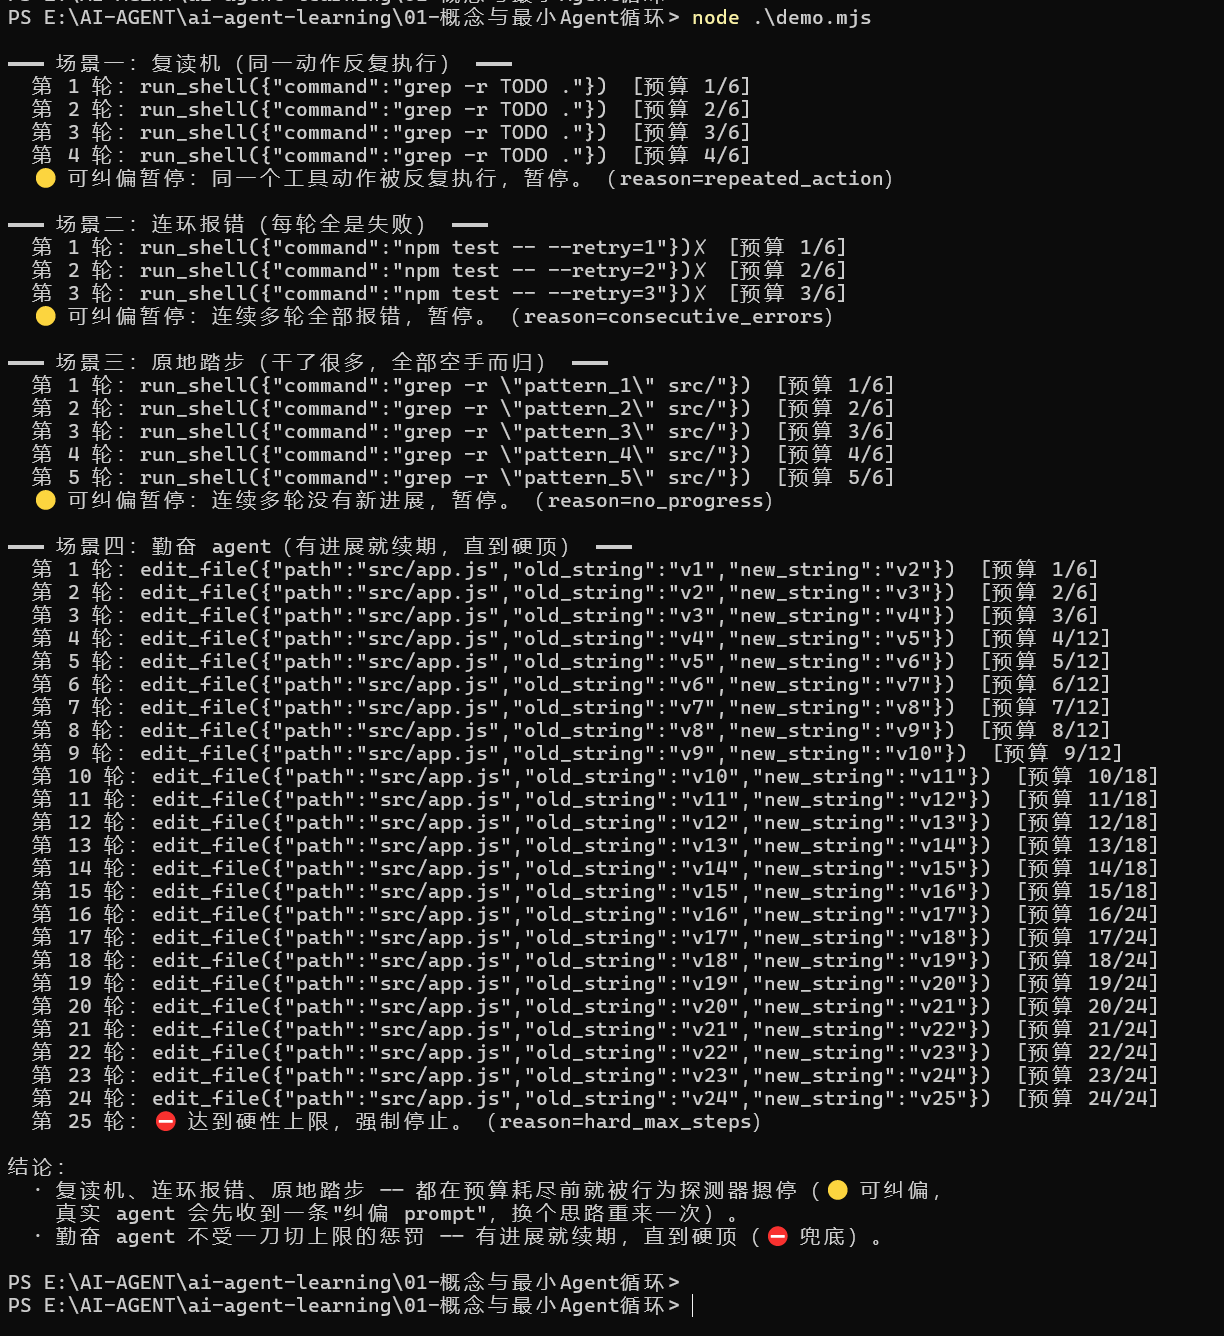
四个剧本 agent 分别演示三种失控被暂停、以及正常推进的 agent 拿到续期。
练习:#
给
isProgress加一条规则:run_shell跑git commit这类明确改变外部状态的命令,即使是第二次也算进展。想想怎么判定"改变外部状态的命令"(提示:白名单前缀即可,不必过度设计)。思考题:纠偏提示是以
role: "user"注入的——模型会把它当成用户说的话。有什么副作用?如果换成 system 消息或 tool 消息,各有什么问题?(这个问题没有标准答案,真实产品各有取舍。)当前:
- js
1 2 3 4 5 6 7if (isRecoverable(stop) && !repaired) { // 熔断不是死刑:告诉模型它为什么被摁停,给它一次换路的机会。 repaired = true; console.log(`\n\x1b[35m🟡 看门狗触发(${stop.reason}),注入纠偏 prompt…\x1b[0m`); messages.push({ role: "user", content: repairPrompt(stop) }); continue; } **模型会把看门狗的话当成"用户说的"。**纠偏文案语气是命令式的(“不要再重复……"),模型会当成用户在发指令。功能上它确实听话了(这是它"有效"的原因),但会产生归因错误:以后用户问"你刚才为什么换思路?",模型可能答"您刚才让我换一条路”——它把看门狗的话安到了用户头上。
**这段内部诊断信息永久留在对话历史里。**messages 是跨轮复用的数组,这条假"用户"消息会一直待在里面,跟真用户的话混在一起。s08 做持久化、s06 做上下文压缩时,它会被当成一段用户发言处理,可能被错误地摘要、引用。
本质上是"非用户的来源塞进了用户槽位"——这和提示注入是同一个机制(对话里出现"说话者不是本人"的内容影响模型行为)。只不过这次是我们自己注入的、可信的,所以没出事,但这个通道本身是敏感的。
轻微但真实:历史记录/截图里会出现一条用户并没有说过的责骂式消息,人回看时一头雾水。
换成 role: “system”
好处:权威性高,模型把它当指令而不是陈述;语义也更诚实(“系统在告诉我空转了”)。但有问题:
位置受限——这是最要命的。OpenAI 兼容 API 普遍要求 system 消息在开头、且往往只能有一条。往对话中间插一条 system,有的 API 直接报错,有的悄悄忽略,有的行为不一致。你现在的 chat() 里第一条就是 system(role: “system”, content: SYSTEM),再塞一条中间 system 很可能出事。
会被上下文压缩/截断特殊对待:很多产品压缩历史时对 system 有特殊处理(只保开头那条),中段的 system 消息容易被丢掉——丢了纠偏就白给了。
权威性通胀:system 几乎不可违抗。看门狗也会误报(见练习 1 的漏报/误报讨论),如果一条错误的"system 指令"让模型停止一个本该继续的任务,后果比"用户消息被怀疑"严重得多。
换成 role: “tool”
问题更直接:
协议上不合法:tool 消息必须对应一个 tool_call_id,且前面要有一条带工具调用的 assistant 消息。凭空塞一条 tool 消息,API 会拒绝或语义错乱。你只能伪造一个假工具调用来配它——这本身就是 hack。
语义错位:模型读 tool 消息时,把它当成"我上一步动作的结果",而不是"接下来该怎么做"。纠偏是一条指令,不是"结果",放进 tool 槽位它基本不会被当指令执行,效力大打折扣。
模型还可能把纠偏文案误认成"我上次工具调用的输出",归因又错了。
一个常见折中:
- 继续用 user,但加标记——把内容改成 【系统】自动纠偏触发:…,让模型和人都能区分"这不是用户本人说的"。你可以在 SYSTEM 里补一句"看到【系统】前缀的消息是自动注入的,不是用户的话,但请照做"。既绕开 API 位置限制,又部分修复归因问题。
- 用 role: “developer”(OpenAI 新角色):system 的权威、但被设计成可放对话流,不过不是所有兼容端点都支持,移植性差。
- 让模型看不到它:纠偏完全在程序侧做(比如直接改预算、换参数),不注入任何消息——最干净,但也放弃了"让模型自己理解并换路"的好处。
当前代码:
| |
“write_file”, “edit_file” 从工具名就知道它改变了状态,所以永远算,但 run_shell 能跑任何命令,光从工具名分不出来,git commit 第二次跑就不算进展,于”连续 commit 俩次“会被当成原地踏步,这就是要修的假阴性。
- 黑名单是列不全的,
- 白名单方案:只有确定改状态的命令才算。范围有限、可预期、好扩展。拿不准的一律当"读"(要求新信息 / 第一次才算)。
| |